Contents
- 01.AI計算基盤の設計思想
- 02.構築時の苦労話
- 03.まとめ
#その他 #AI #GPUサーバー
2026.10.22
ソフトバンク株式会社
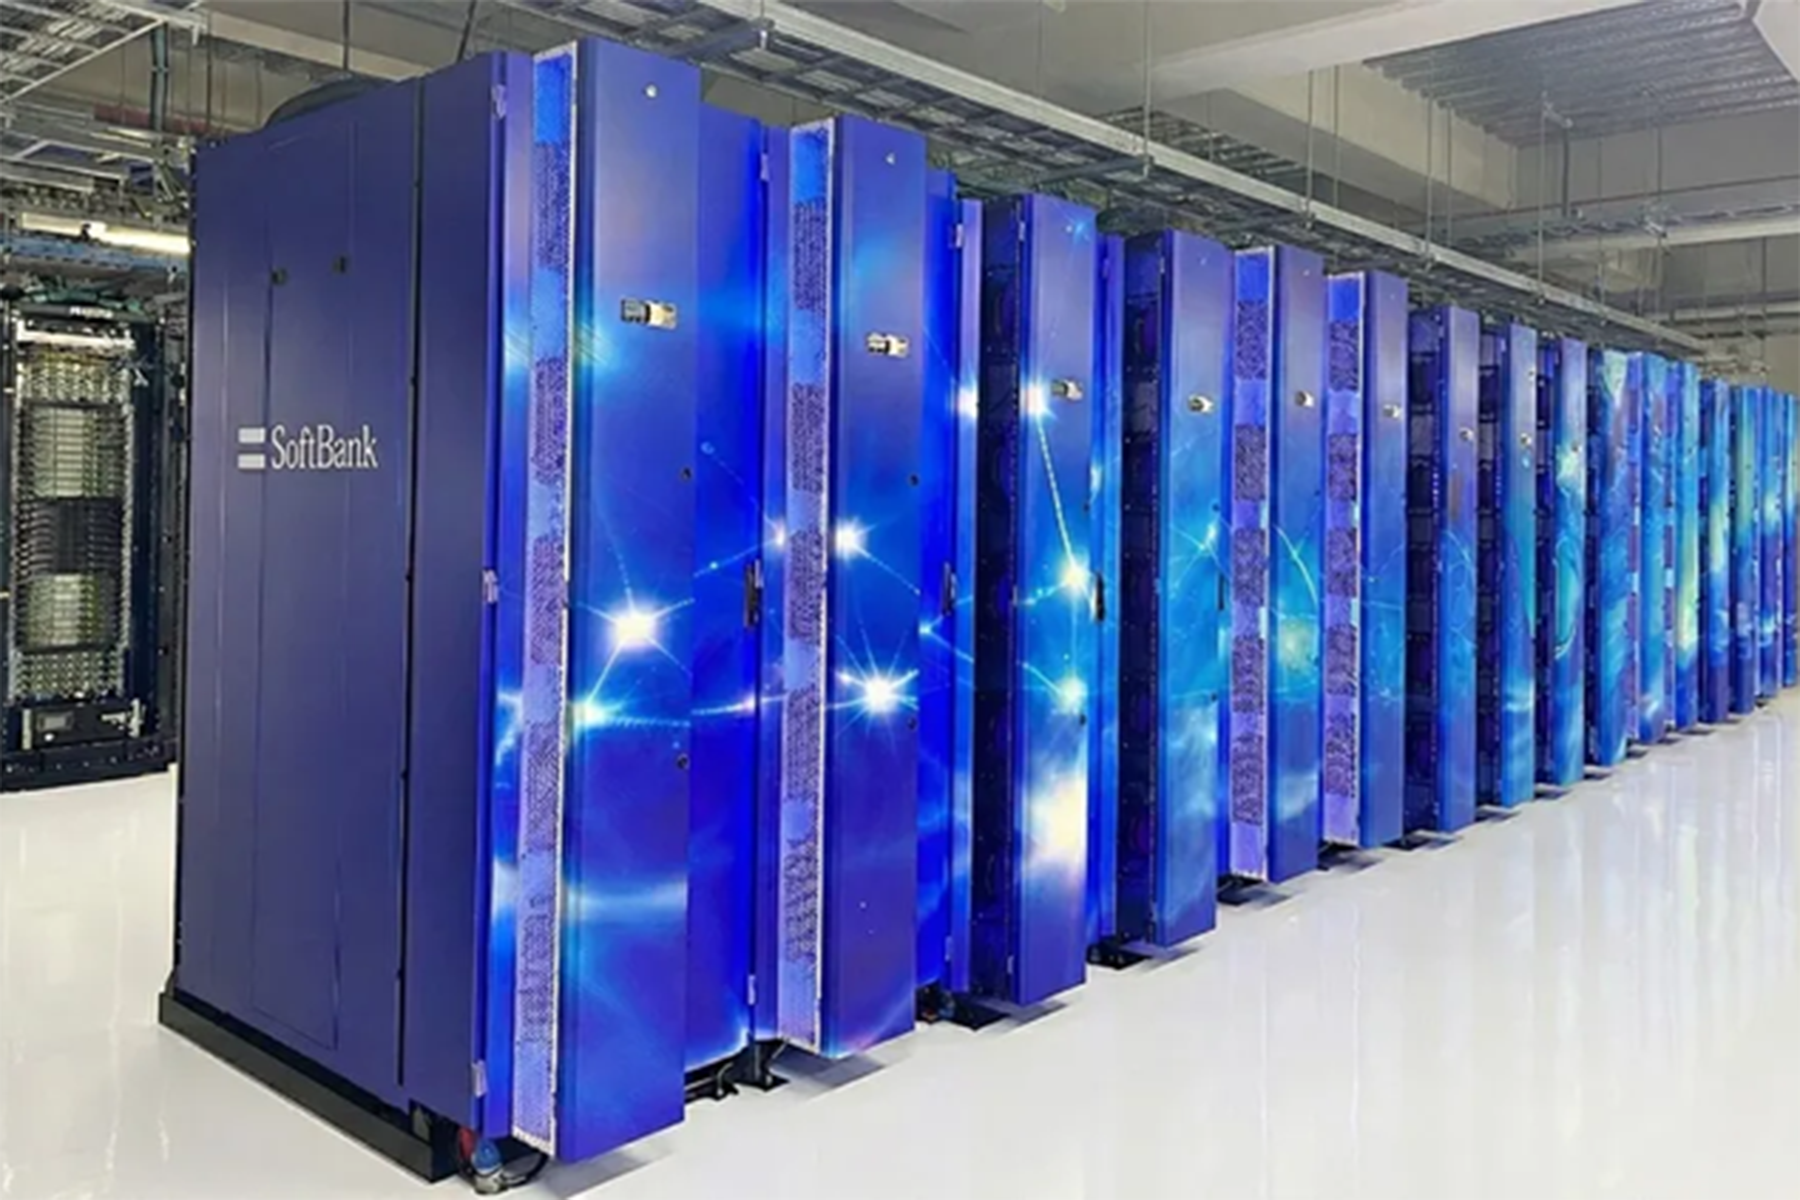
生成AIの急速な普及に伴い、大規模なGPUを高速ネットワークで接続するAI計算基盤の重要性が高まっています。ソフトバンクでは2023年からAI計算基盤を稼働させ、継続的に新しい基盤の構築を進めてきました。
そして新たに取り組んだのが、ラック全体を一つのシステムとして扱う「Rack-Scale GPUサーバー」です。
Rack-Scale化によって変わったのは、GPUサーバーの性能だけではありません。液冷、電源、スイッチ、Optics、ケーブリング、さらにはデータセンターのファシリティまで、ネットワークエンジニアが考慮すべき領域が大きく広がりました。
本記事では、Rack-Scale GPUサーバーのネットワークを構築する中で直面した課題と、それらをどのように解決したのかを紹介します。ネットワーク設計だけでなく、数万規模のインターフェースを扱うケーブリング、ネットワーク機器の物理層のトラブルシューティング、液冷設備の運用など、実際の構築を通して得られた知見を解説します。
※本記事は、JANOG58 MEETING in Matsuyamaで発表された「Rack-Scale GPUサーバーのNW設計と運用までの苦悩」の登壇内容・資料をもとに、Rack-Scale GPUサーバーのネットワーク設計・構築・運用で得られた知見を整理したものです。
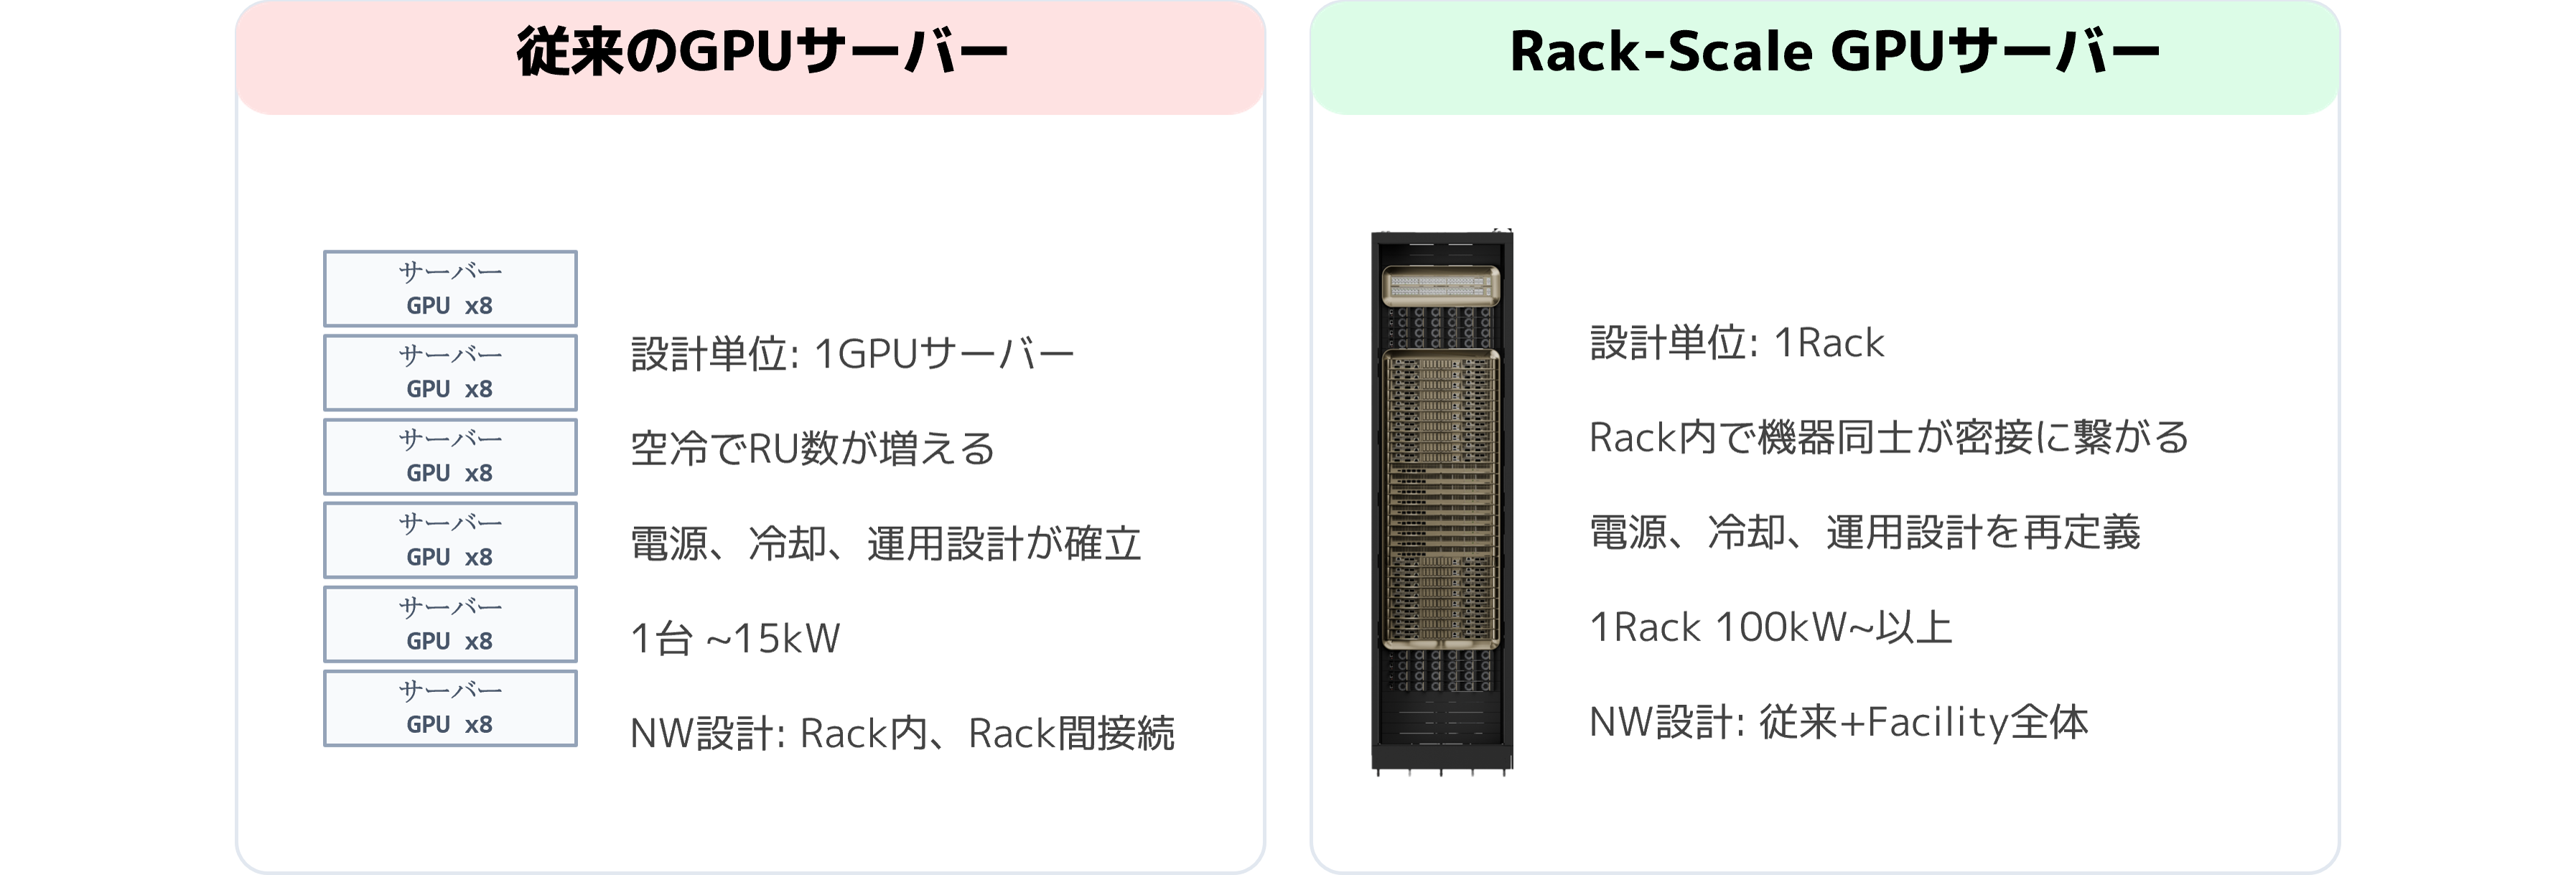
従来のGPUサーバーでは、サーバー単体を基本として電源、冷却、ネットワーク、運用を設計していました。空冷GPUサーバーについては構築・運用の経験も蓄積され、一定の設計パターンを確立できていました。
しかし、Rack-Scale GPUサーバーでは設計の考え方が大きく変わります。
ラック内部のCompute TrayやNVLink Switch Trayなどが高速インターコネクトによって密接に接続されるため、サーバー単体ではなく、ラック全体を一つのシステムとして設計する必要があります。
さらに今回の構築では、液冷への対応やEthernetを利用したネットワークの構築、ファシリティとの新たな調整なども必要になりました。
その結果、ネットワークだけを見るのではなく、電源や冷却を含めたラック全体の構造を理解することが、ネットワーク設計の前提となりました。
Rack-Scale GPUサーバーのネットワークを設計するためには、最初にラック内の各コンポーネントがどのような役割を持っているのかを理解する必要があります。
今回扱ったラックでは、OCP(Open Compute Project)のORv3ラックが採用されています。
一般的な19インチEIAラックとは異なり、ORv3 は 21 インチ幅です。また、ラック背面には各機器へ電力を供給する「Busbar」が配置されています。
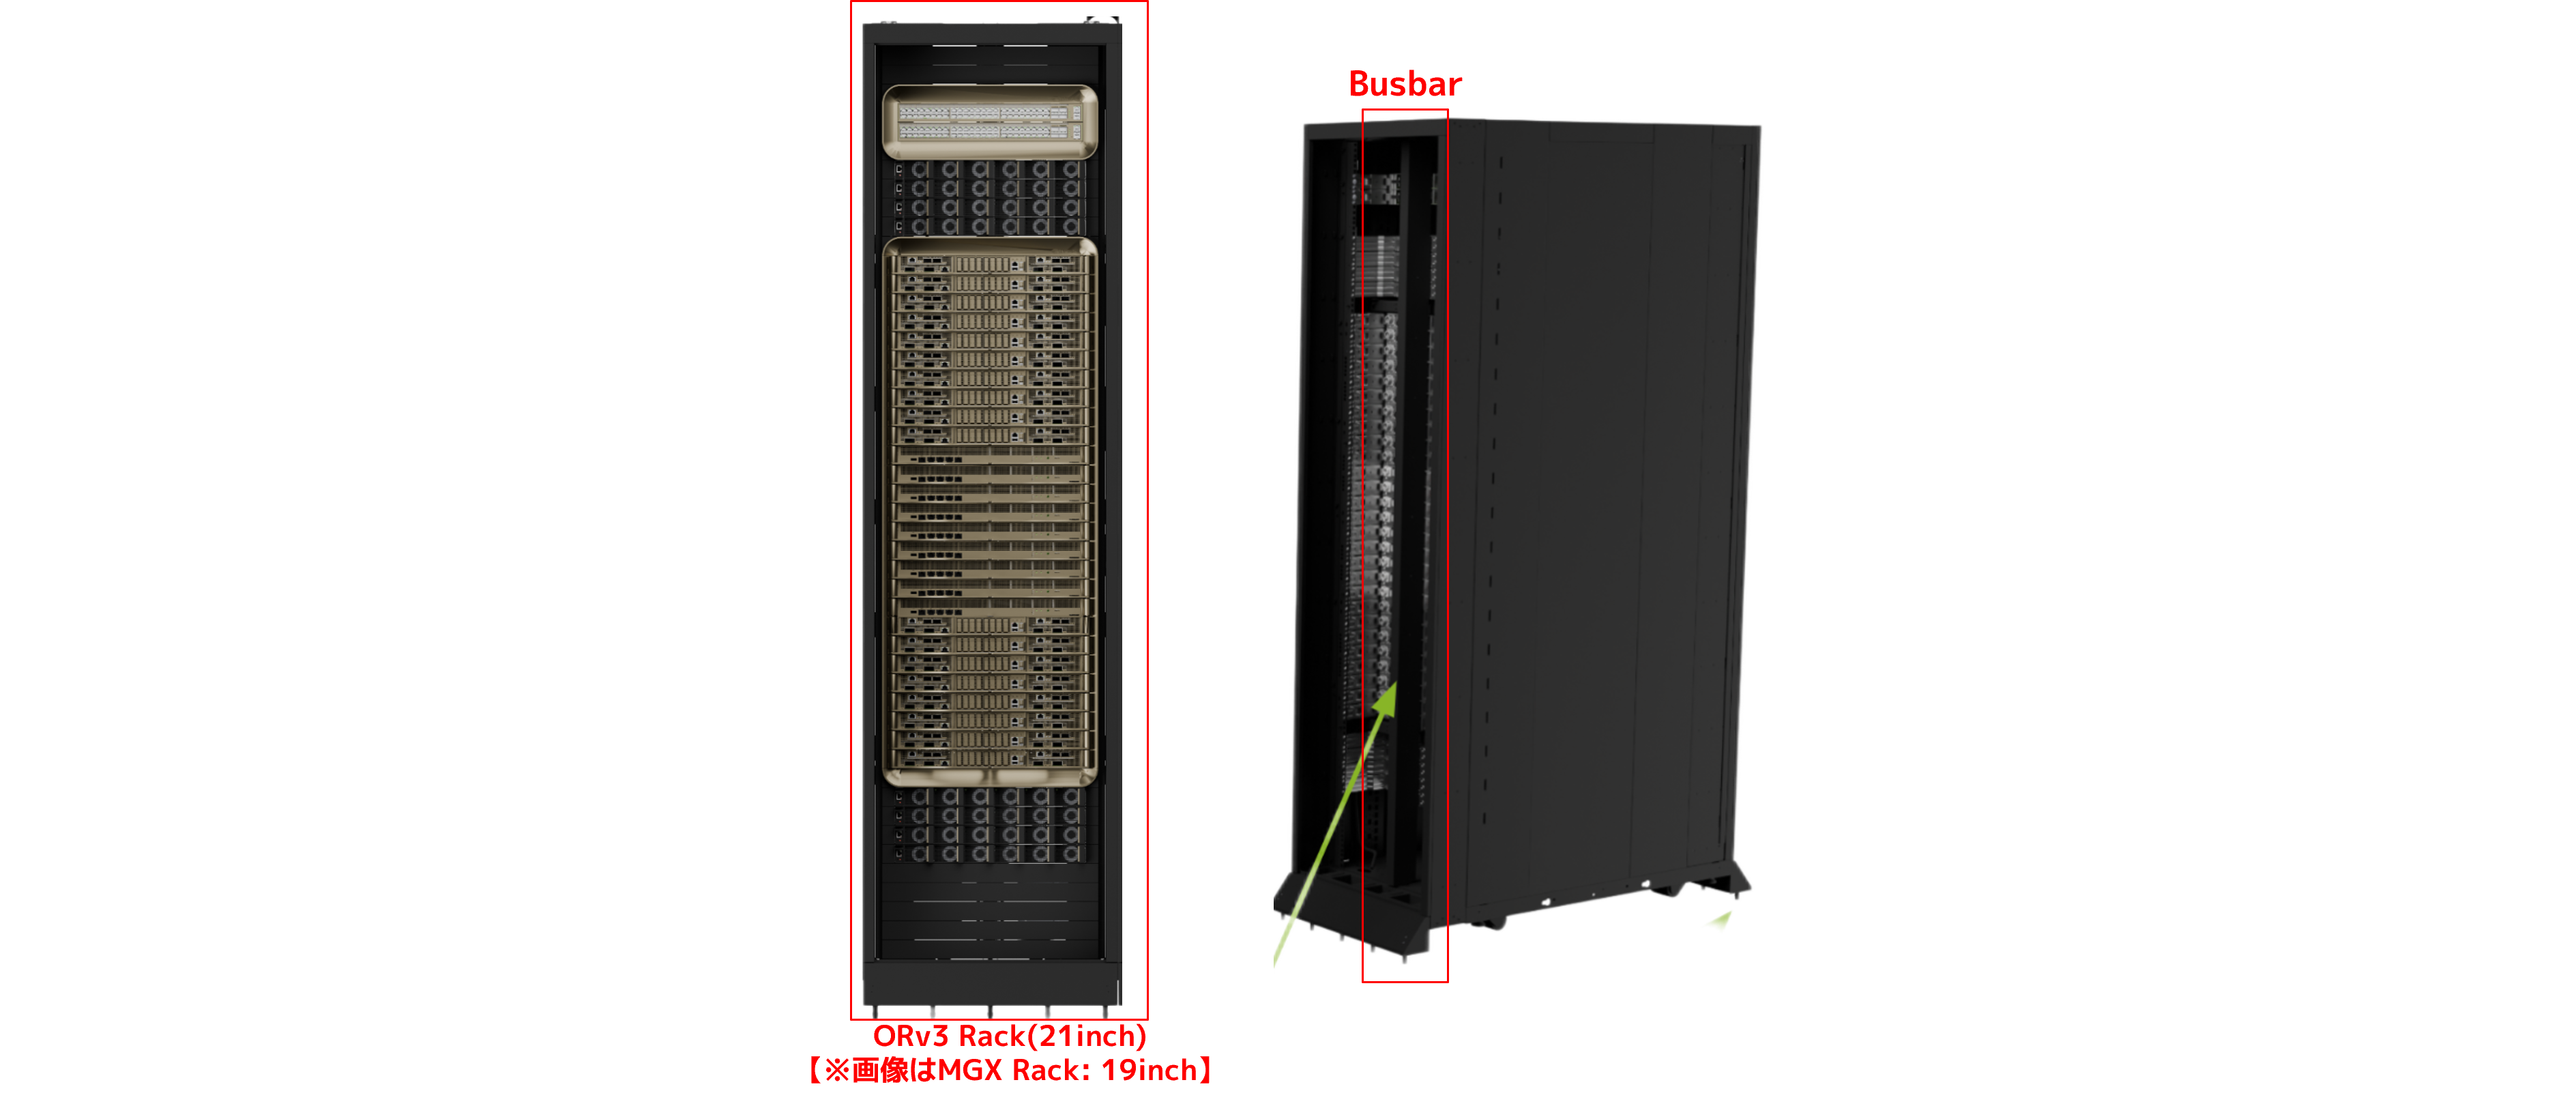
NVIDIA DGX GB Rack Scale Systems – Busbar
従来のネットワーク機器では、各機器にPSUを搭載して電力を変換する構成が一般的でした。一方、Rack-Scale GPUサーバーではPower Shelfによって電力変換を集約し、Busbar経由でラック内の機器へ電力を供給します。
ラック内部には複数のCompute Trayが搭載され、それぞれでOSが動作します。
Compute Tray間の高速通信にはNVLink Switchが利用されます。各TrayはNVLink Switchを介して接続され、ラック背面ではNVLink Spineと呼ばれるCable Cartridgeによって高速に接続されています。
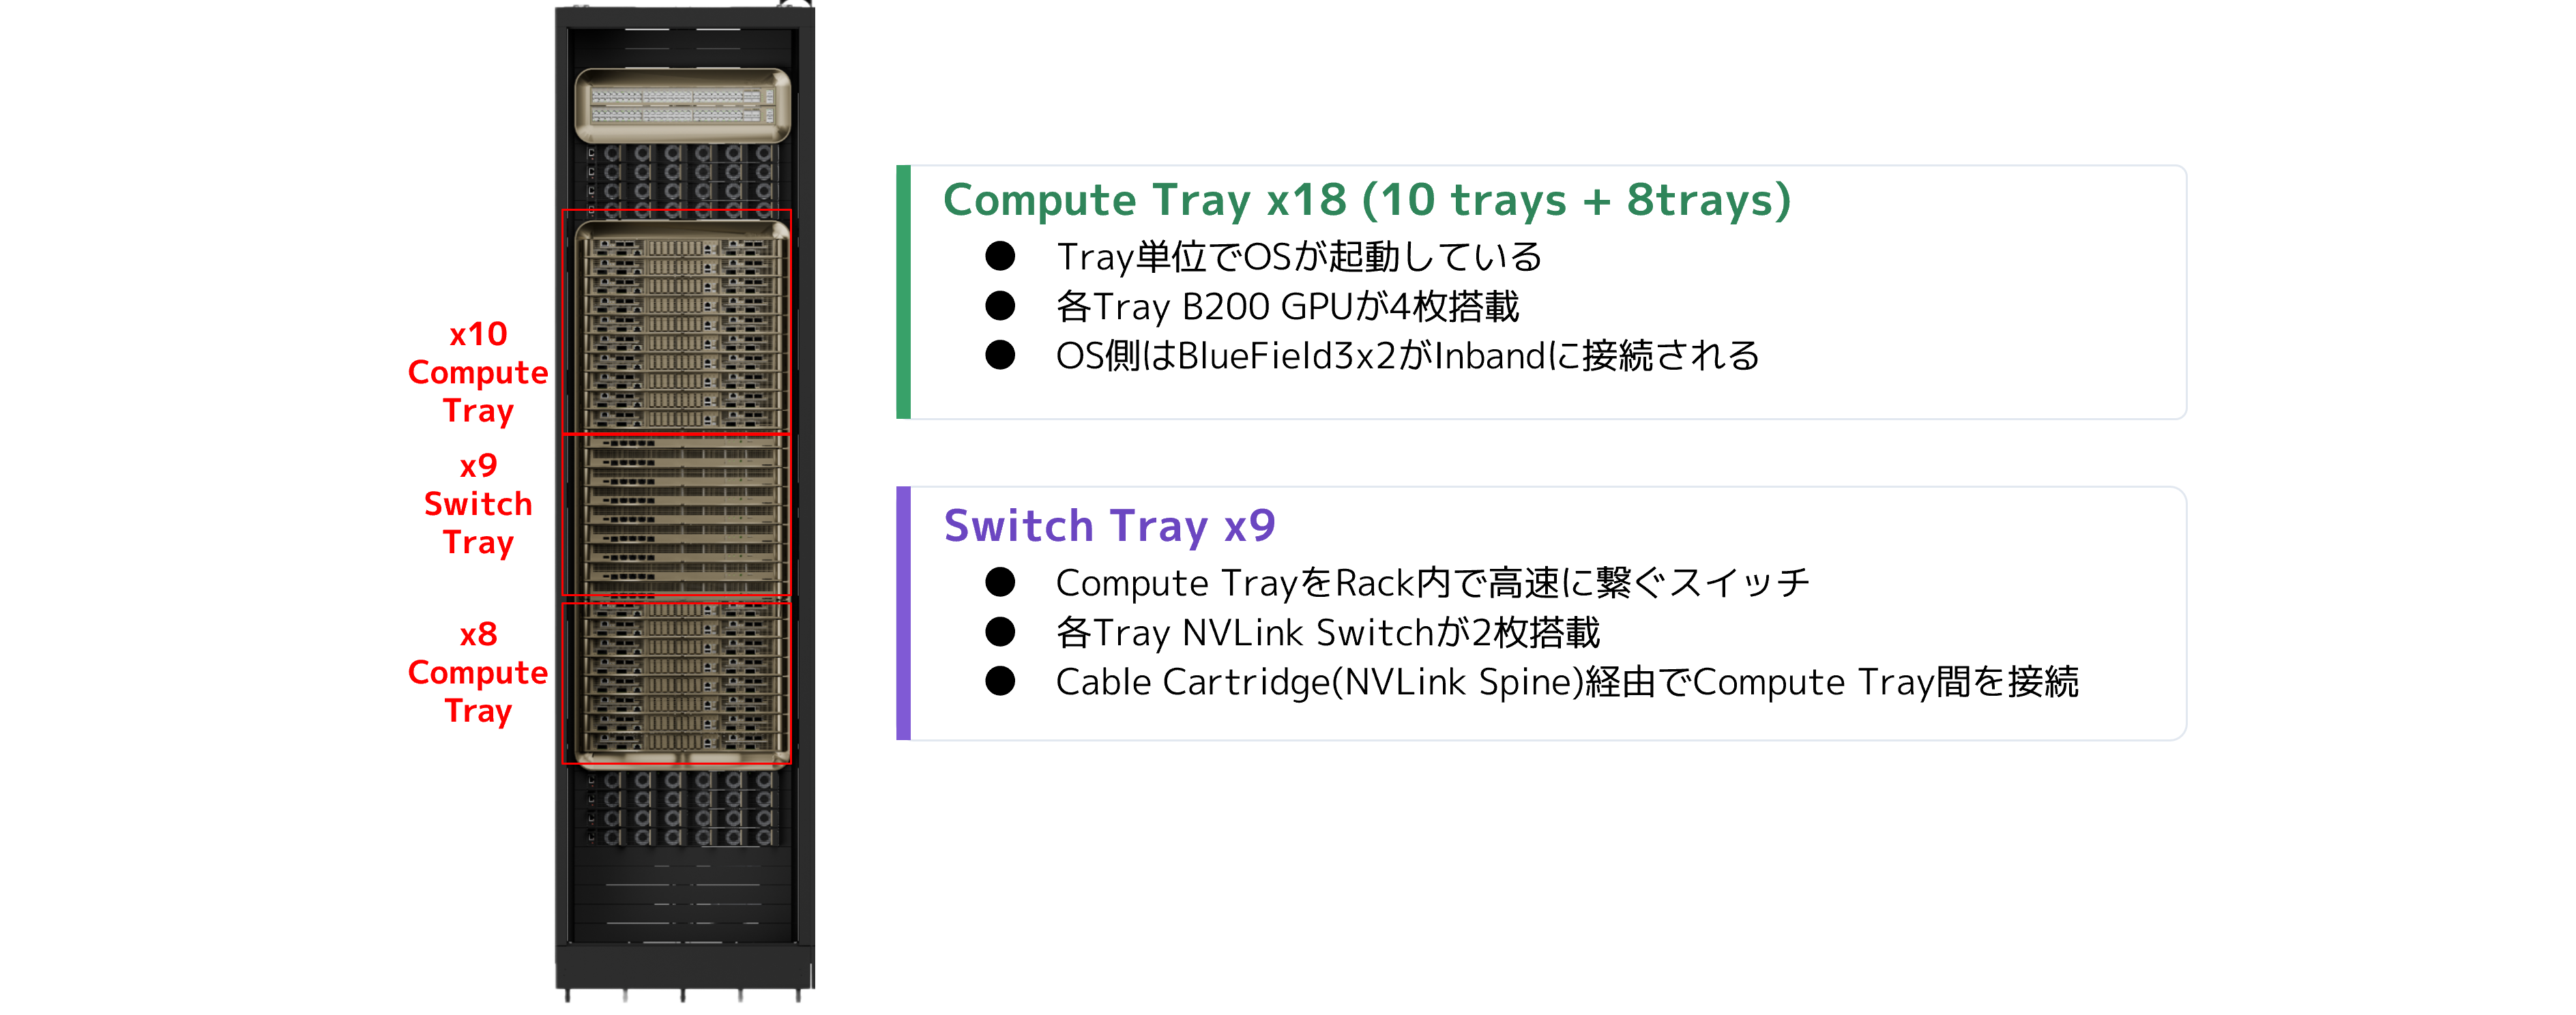
NVIDIA DGX GB Rack Scale Systems – Compute Tray and NVLink Switch Tray
構築作業では、こうした論理構成だけでなく、物理的な配置の把握も重要です。
例えば、ラック内のTray番号が上から割り当てられているのか、下から割り当てられているのかという違いだけでも、配線や機器交換時の作業に影響します。
大規模環境では、このような細かな認識のずれが大量の作業ミスにつながる可能性があります。そのため、納品前の段階から物理構成を確認しておくことが重要です。
Rack-ScaleGPUサーバーでは、液冷設備も重要なコンポーネントです。
CDU(Coolant Distribution Unit)は、冷却液をラック内部に循環させる装置です。単に冷却液を循環させるだけでなく、温度、流量、圧力なども監視します。ラック背面には冷却液を各機器へ分配するマニフォールドもあります。
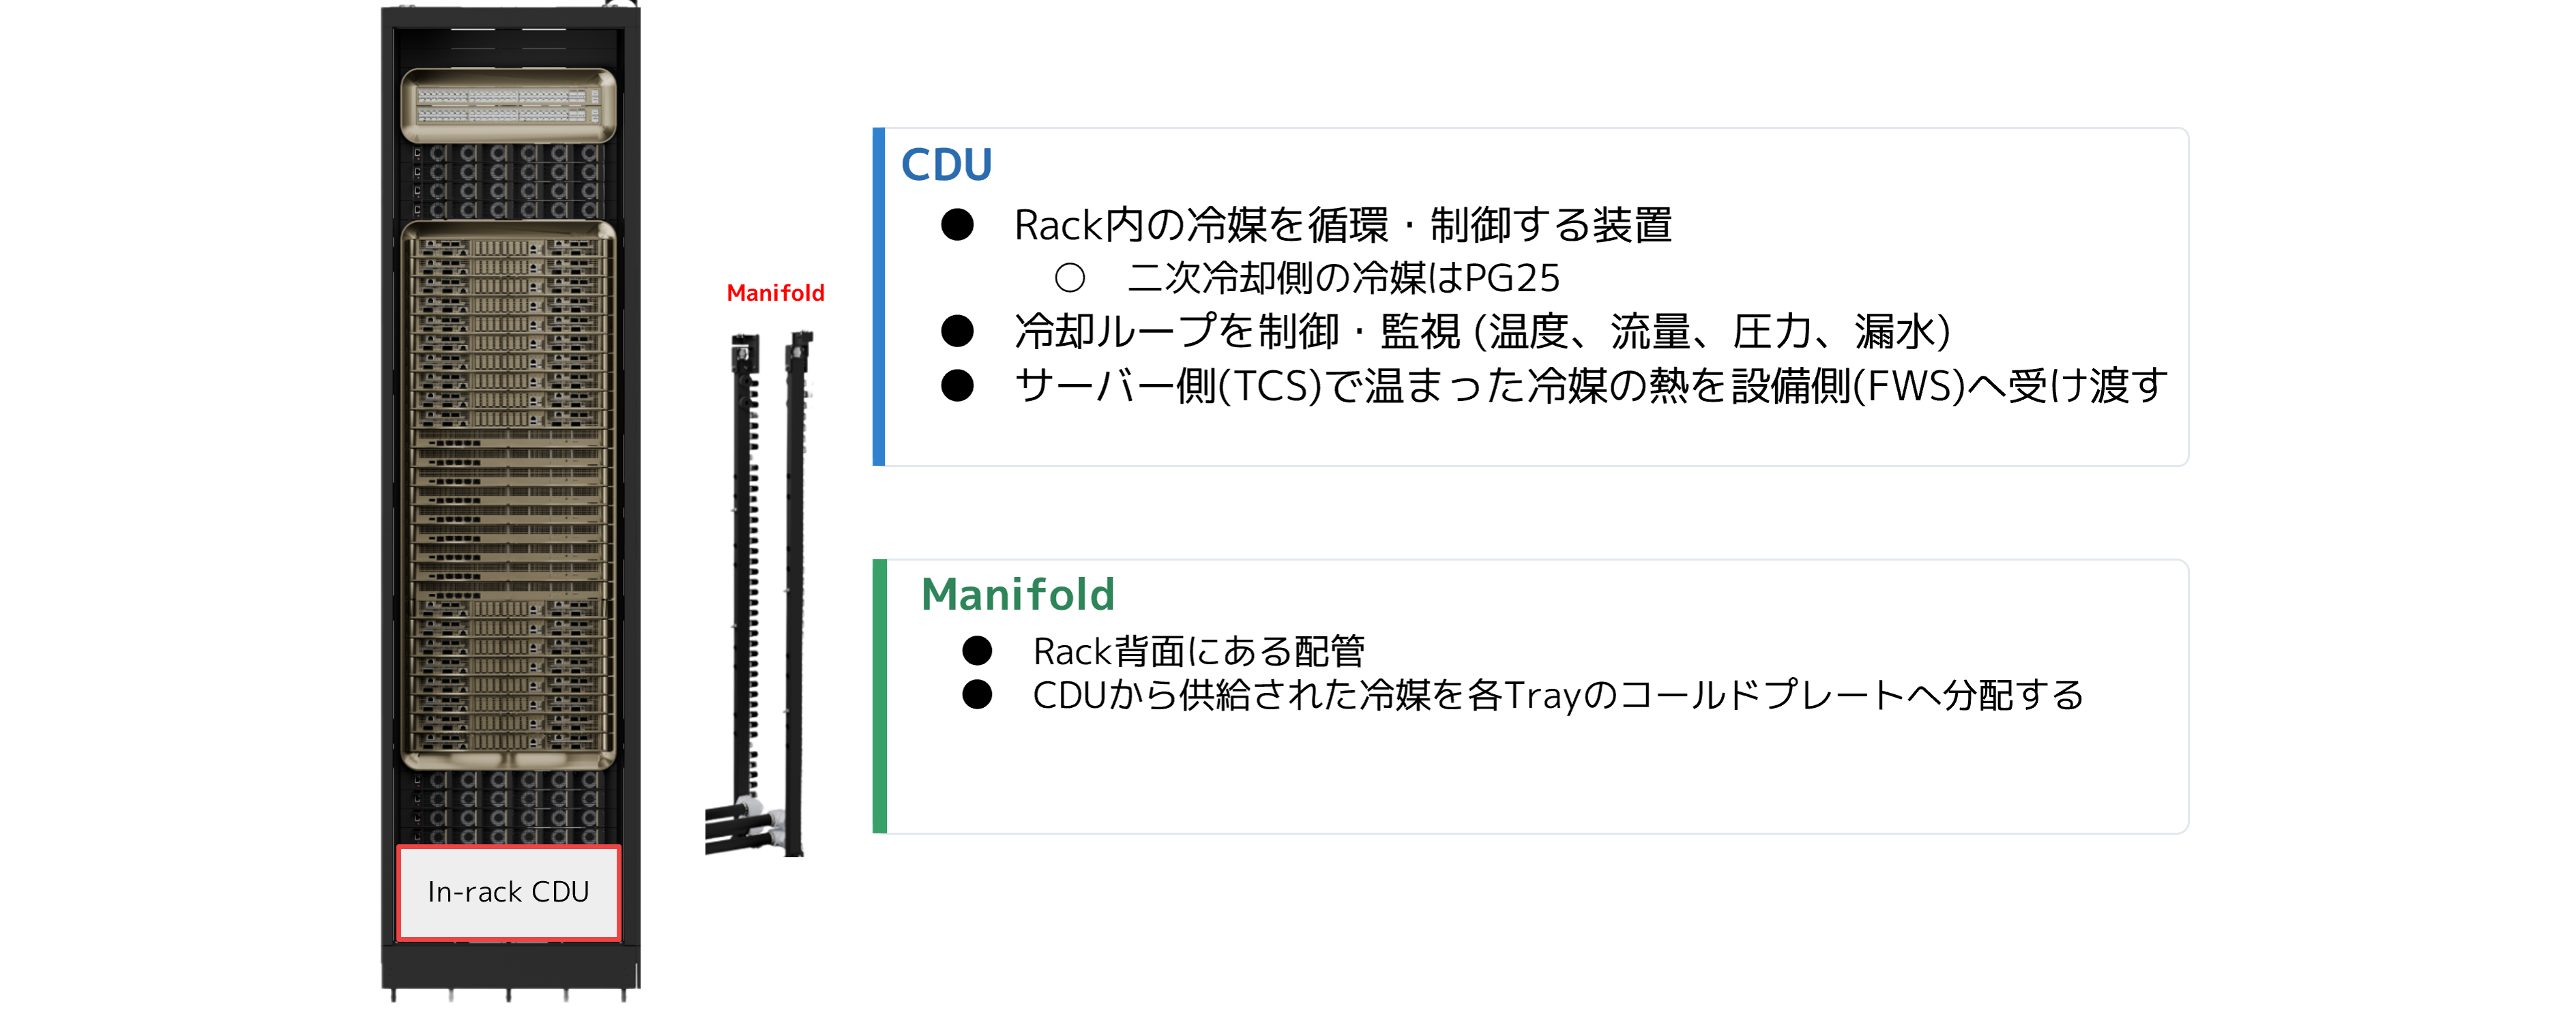
NVIDIA DGX GB Rack Scale Systems – CDU & Manifold
特に注意が必要なのが結露です。冷却液の温度だけを見るのではなく、データセンター内の湿度との組み合わせによって結露が発生する可能性があります。そのため、「現在の湿度で、どの温度まで下がると結露するのか」といった条件を考慮し、データセンター事業者とアラーム条件を調整する必要があります。
ネットワークエンジニアであっても、今後液冷機器を扱う場合には、こうした冷却設備の構造や規格まで理解する必要があります。なぜなら、CDUの配置場所によってラック内の配線・整線のルートや方法が大きく変わるうえ、将来的な水冷スイッチの導入に向けた規格へのキャッチアップや、運用保守体制の見直しが不可欠となるためです。
ラック内部の構成を理解したうえで、ラック間を接続するNetwork Fabricを設計します。
今回の環境では、大きく分けて以下の3種類のFabric を利用しています。
・Compute Fabric
・Converged Fabric
・OOB Fabric
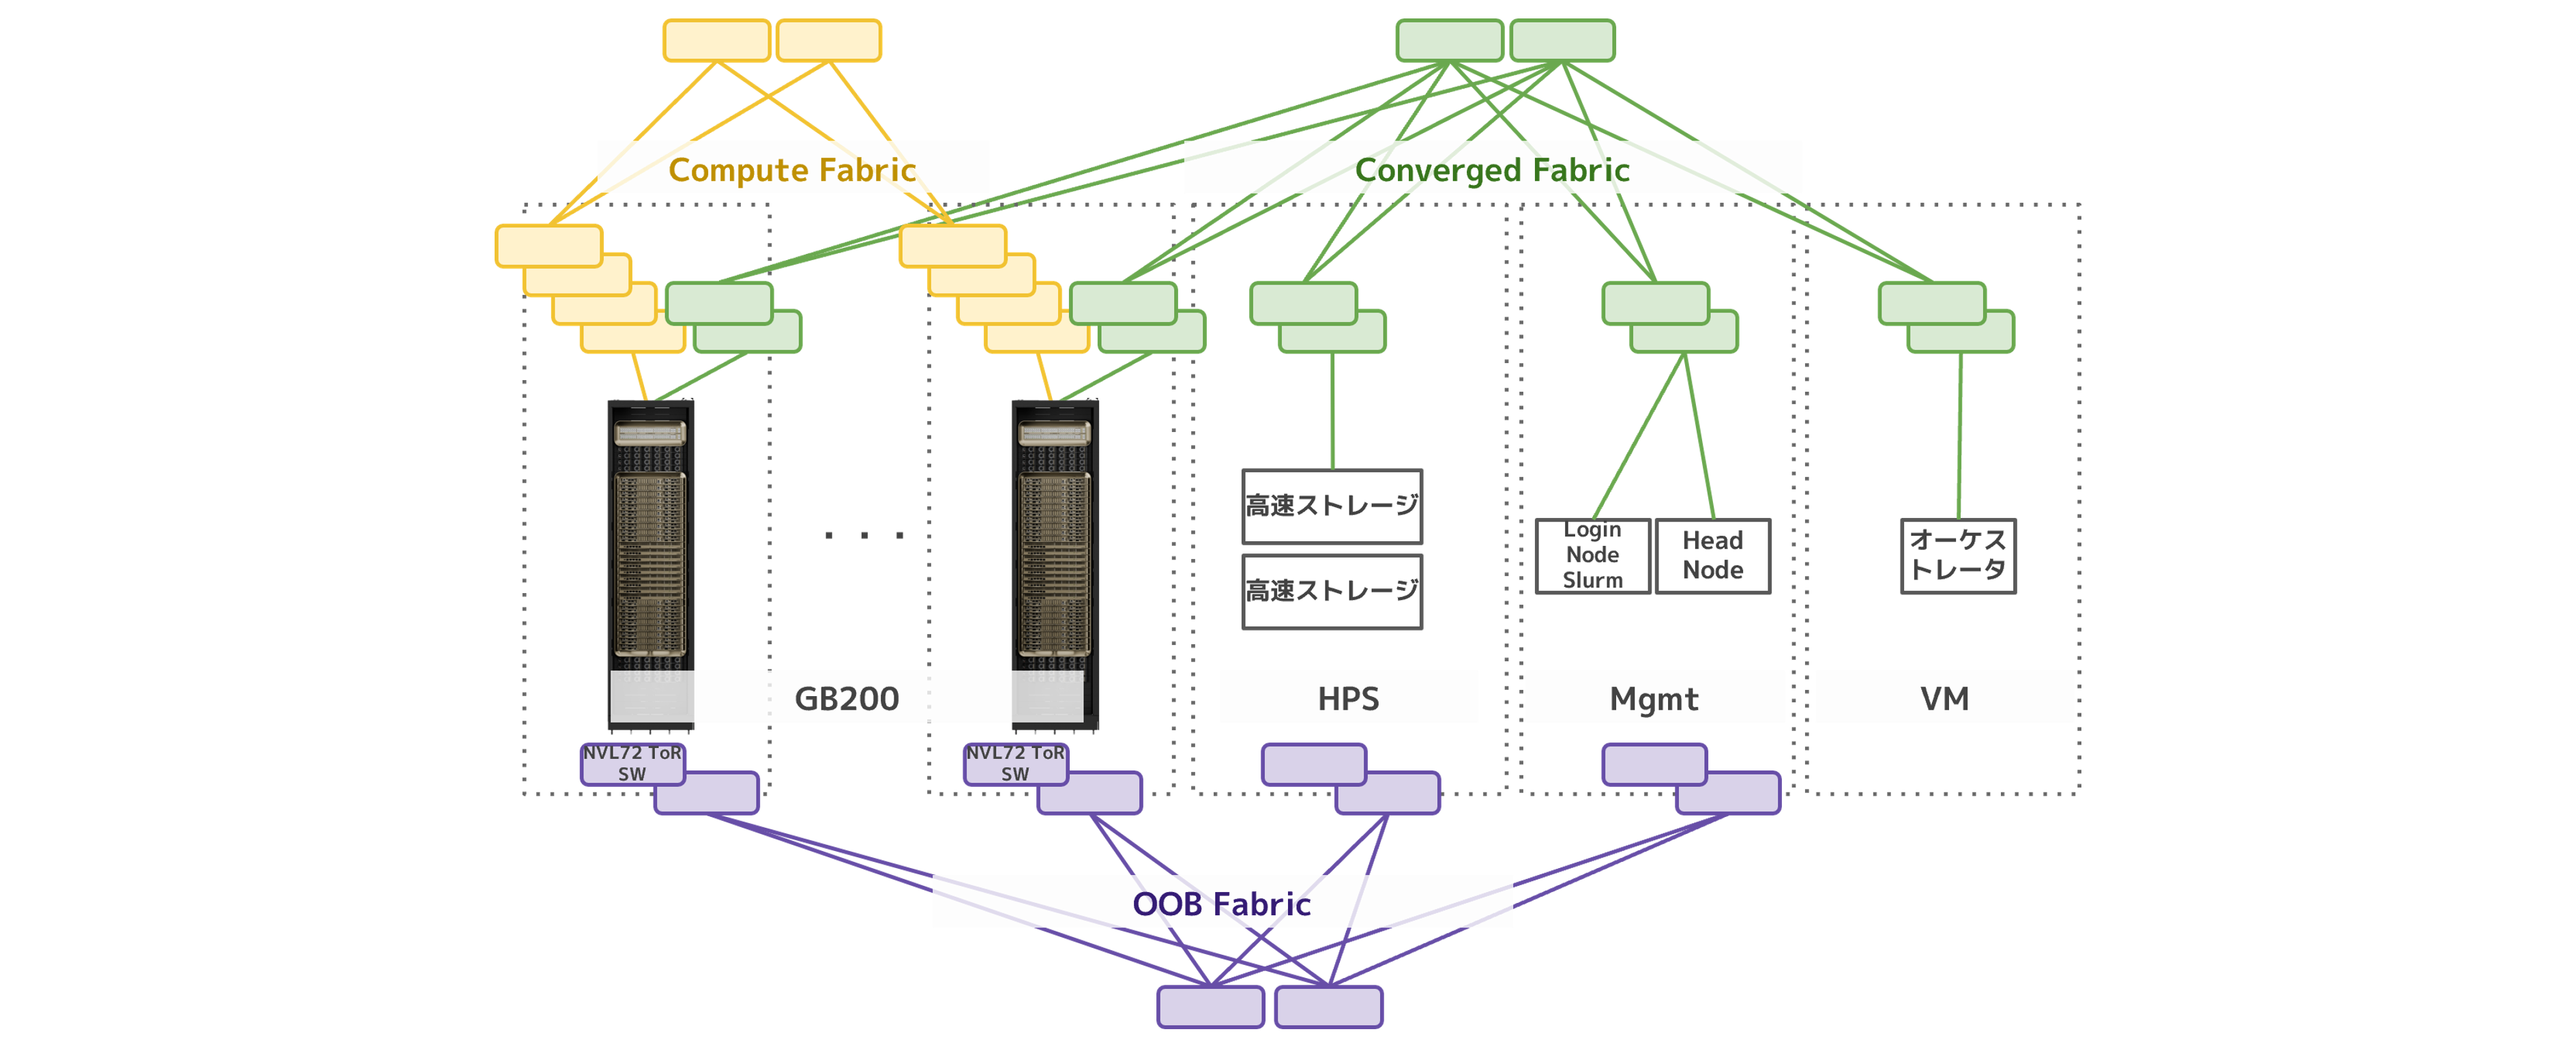
SoftBank NVL72 GB200ネットワーク全体のイメージ図
Compute Fabricは、GPU間の高速通信を担うネットワークです。
GPU側のNICとLeaf Switchを接続し、障害発生時の耐障害性なども考慮しながら構成します。
ソフトバンクでは、Compute FabricのトラフィックバランシングにAdaptive RoutingやBGP、ECMPなどを活用しています。
大規模なAI計算基盤では大量のGPUが同時に通信するため、単純に広帯域なネットワークを構築するだけではなく、トラフィックをどのように分散するかも重要になります。
Converged Fabricは、インターネットアクセスなどに利用するフロントエンドネットワークと、高速ストレージへのアクセスを担うネットワークです。
異なる用途の通信を一つの物理ネットワークへ集約し、論理的に分離して利用します。
特にストレージ通信では、GPUが要求するRead/Write性能に対してネットワークがボトルネックにならないよう、GPU1枚あたりに必要となる帯域を考慮して設計しています。
OOB Fabricは、Rack-Scale時代では単なるサーバー管理網ではなく、ラック設計の重要な要素となります。NVL72ではToR管理スイッチを介し、Compute TrayやNVLink Switchに加え、CDU、Power Shelf、RDHx (Rear Door Heat Exchanger) など電源・冷却設備も監視します。GPUラック全体を一つのシステムとして捉え、Compute・Network・Power・Coolingを横断的に管理する視点が重要になります。
ネットワークの構築後には、GPUリソースをユーザーへどのような単位で提供するかを考える必要があります。主な選択肢は、ラック単位、Tray単位、GPU単位の3つです。
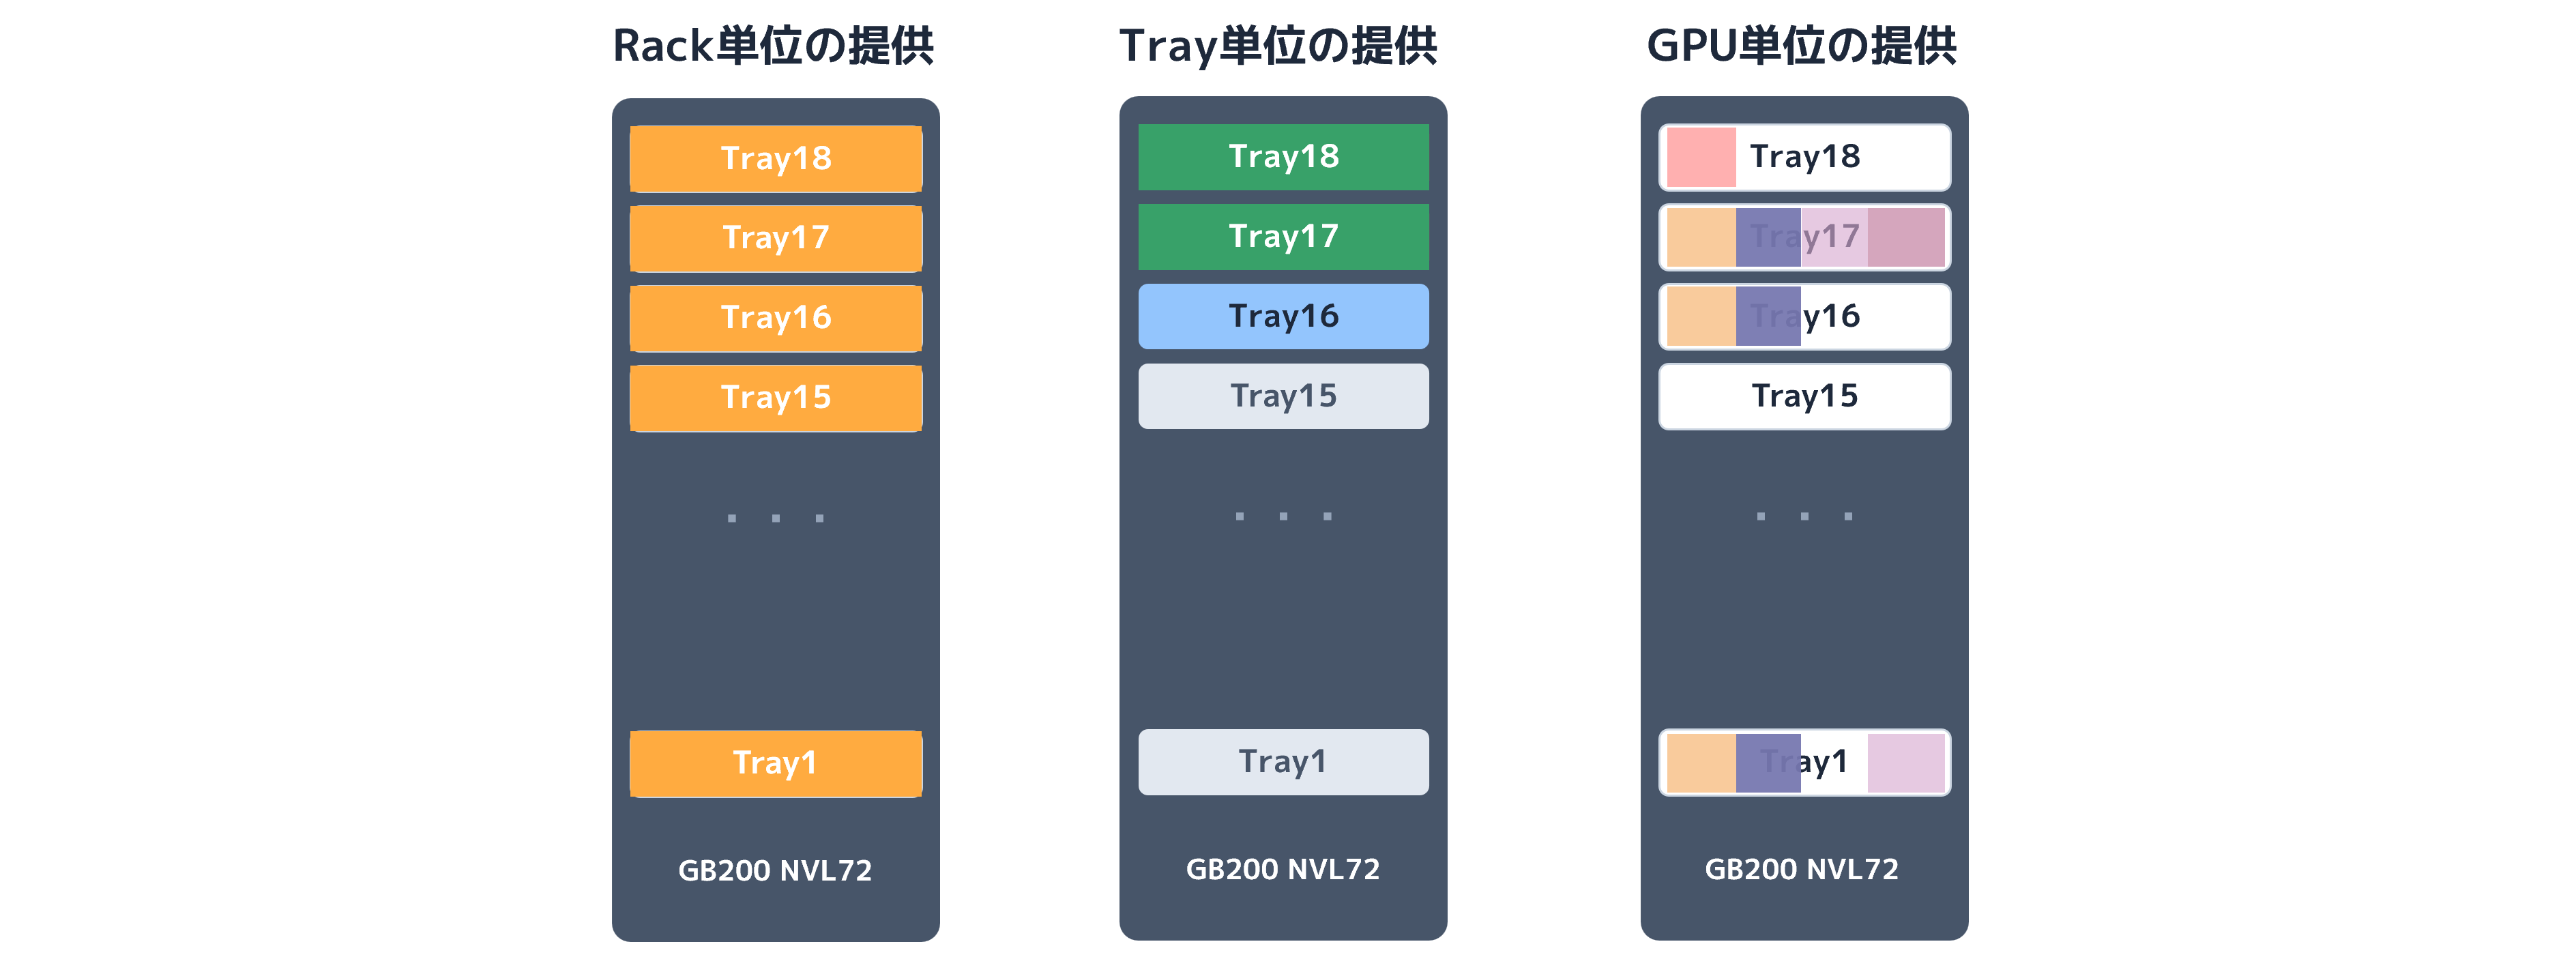
SoftBank NVL72 GB200サービス提供の比較
ラック単位の提供は、大規模ユーザーを想定しています。
ラック全体を一つの単位としてユーザーへ割り当てるため構成がシンプルで、他の提供形態と比較するとサービス化しやすい方式です。
Tray単位では、中規模ユーザーの利用を想定しています。
Compute TrayはNVLink Switchを介して高速に接続されています。そのため複数ユーザーへTrayを提供する場合には、NVLink Switch側でも論理的な分離が必要になります。
ソフトバンクではNVLink Switchのパーティショニングを行い、ユーザーの要求に応じて論理的に分離しています。
さらに細かくGPU単位で提供すれば、小規模ユーザーにもリソースを割り当てられます。一方で、GPUだけを分割すればよいわけではありません。
CPUやメモリといったリソースについても仮想化を考える必要があり、ネットワーク側でもテナントごとの分離が必要になります。そのため、提供単位を細かくするほどリソース効率を高められる可能性がある一方、実装・運用コストも増加します。
以上のトレードオフを踏まえ、現在ソフトバンクでは、GB200のリソースをGPU単位では提供しておらず、ラック単位とTray単位で提供しています。
ここからは、実際の構築現場で発生した課題を紹介します。
AI計算基盤では、GPUを調達した後、可能な限り早期にサービスインすることが重要です。GPUを稼働できない期間が長くなるほど、大規模な初期投資を有効活用できない期間も長くなるためです。
そのため、いかに迅速に基盤を構築し、かつ高品質なネットワークを提供するかという点で、ネットワークエンジニアとしてさまざまな課題に直面してきました。
ネットワークエンジニアにとって大きな課題となるのがケーブリングです。
大規模なAIネットワークでは膨大な結線表が必要になります。結線表にミスがあれば、そのまま現場の配線ミスにつながります。
この問題に対して、物理構成そのものを可能な限り規則化しました。物理構成をシンプルにすると、結線表の作成も容易になります。
例えば、一つの Scalable Unit内でGPUラック、Networkラック、GPUラックという配置を標準化し、GPUサーバーとSwitch間のケーブルやケーブルルートも事前に決めておきます。
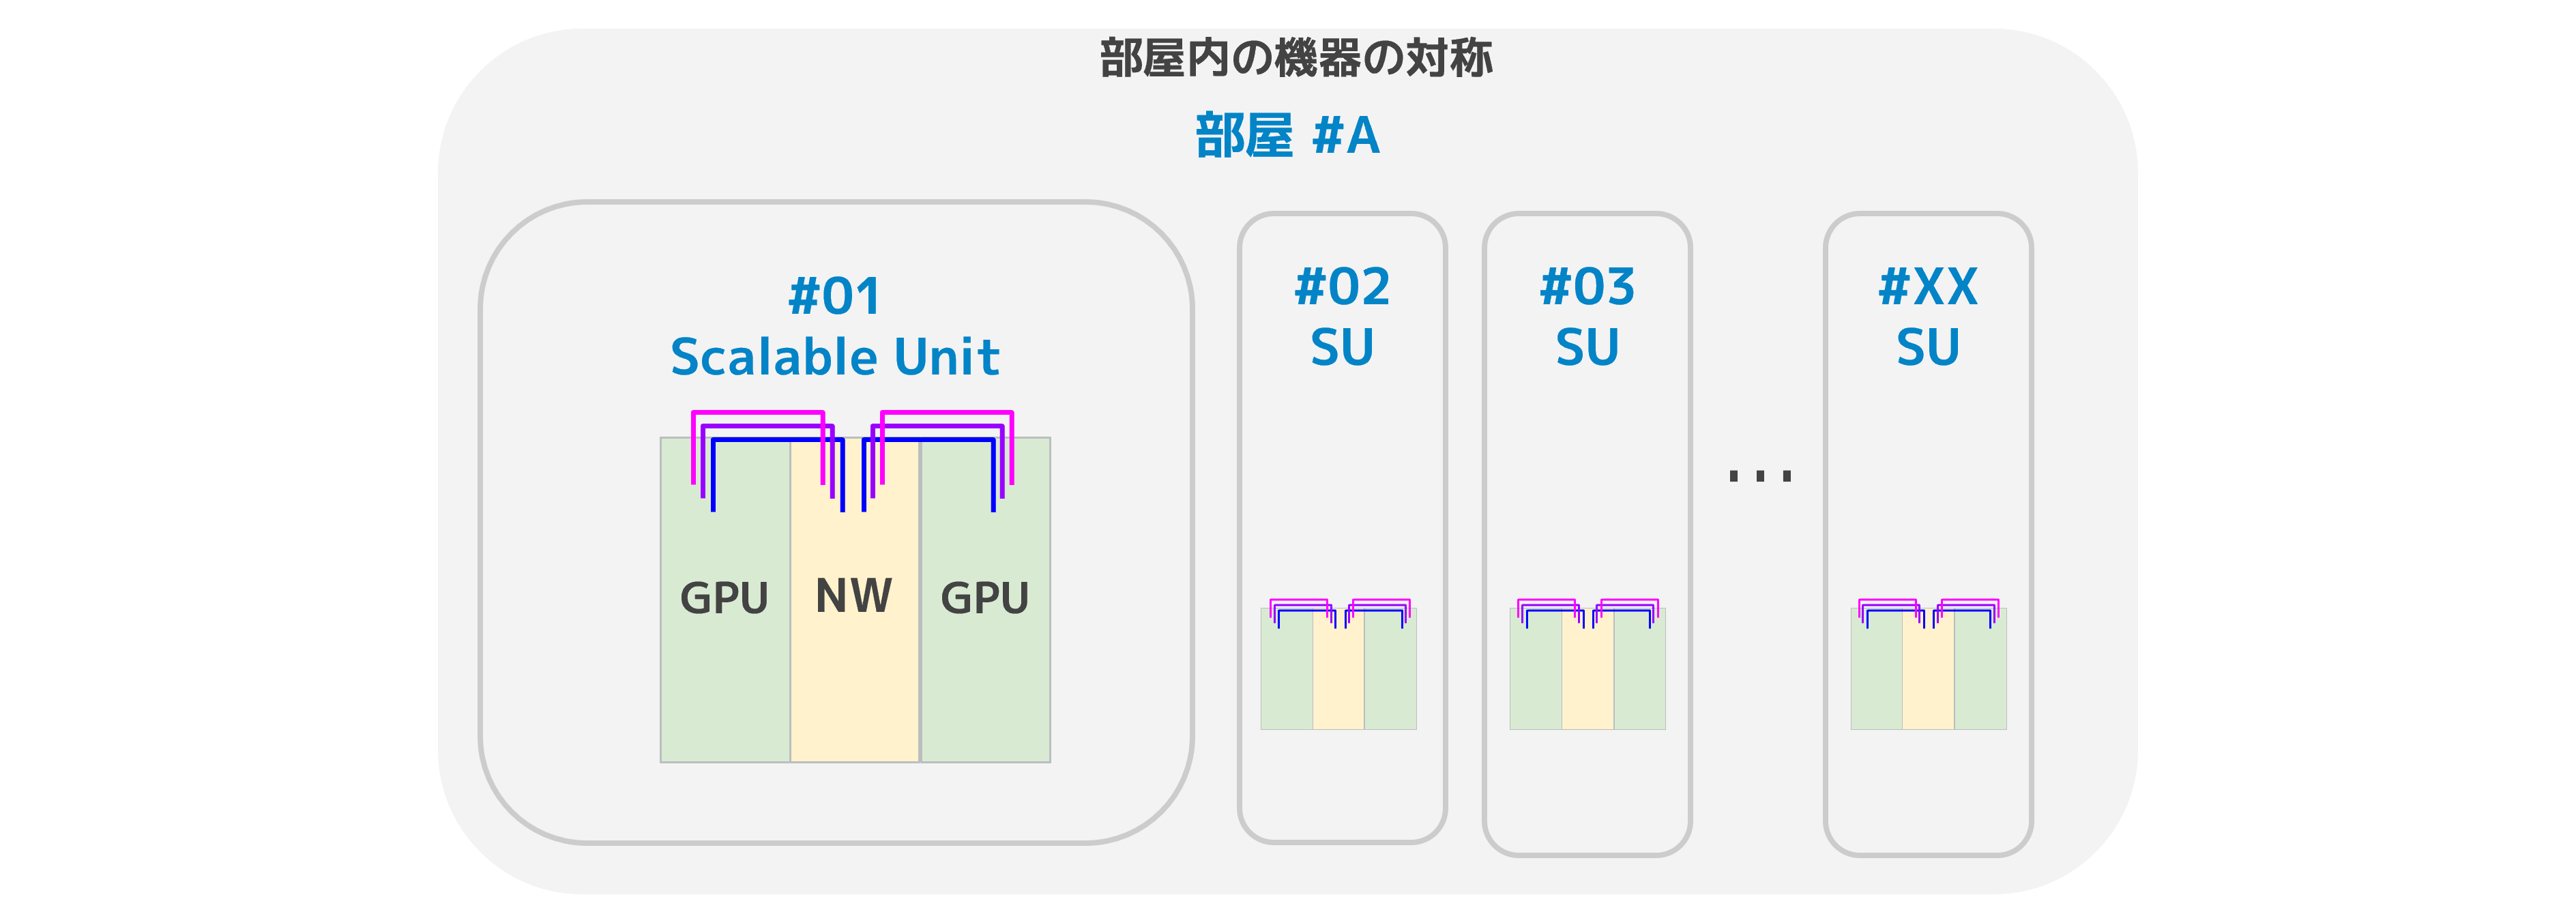
部屋内のSymmetric設計
下図に示す部屋間の構成例のように、左右どちらでも同じ構成になるように対称設計をおこなうことで、Scalable Unitを追加するときには既存構成を「コピー&ペースト」するように拡張できます。
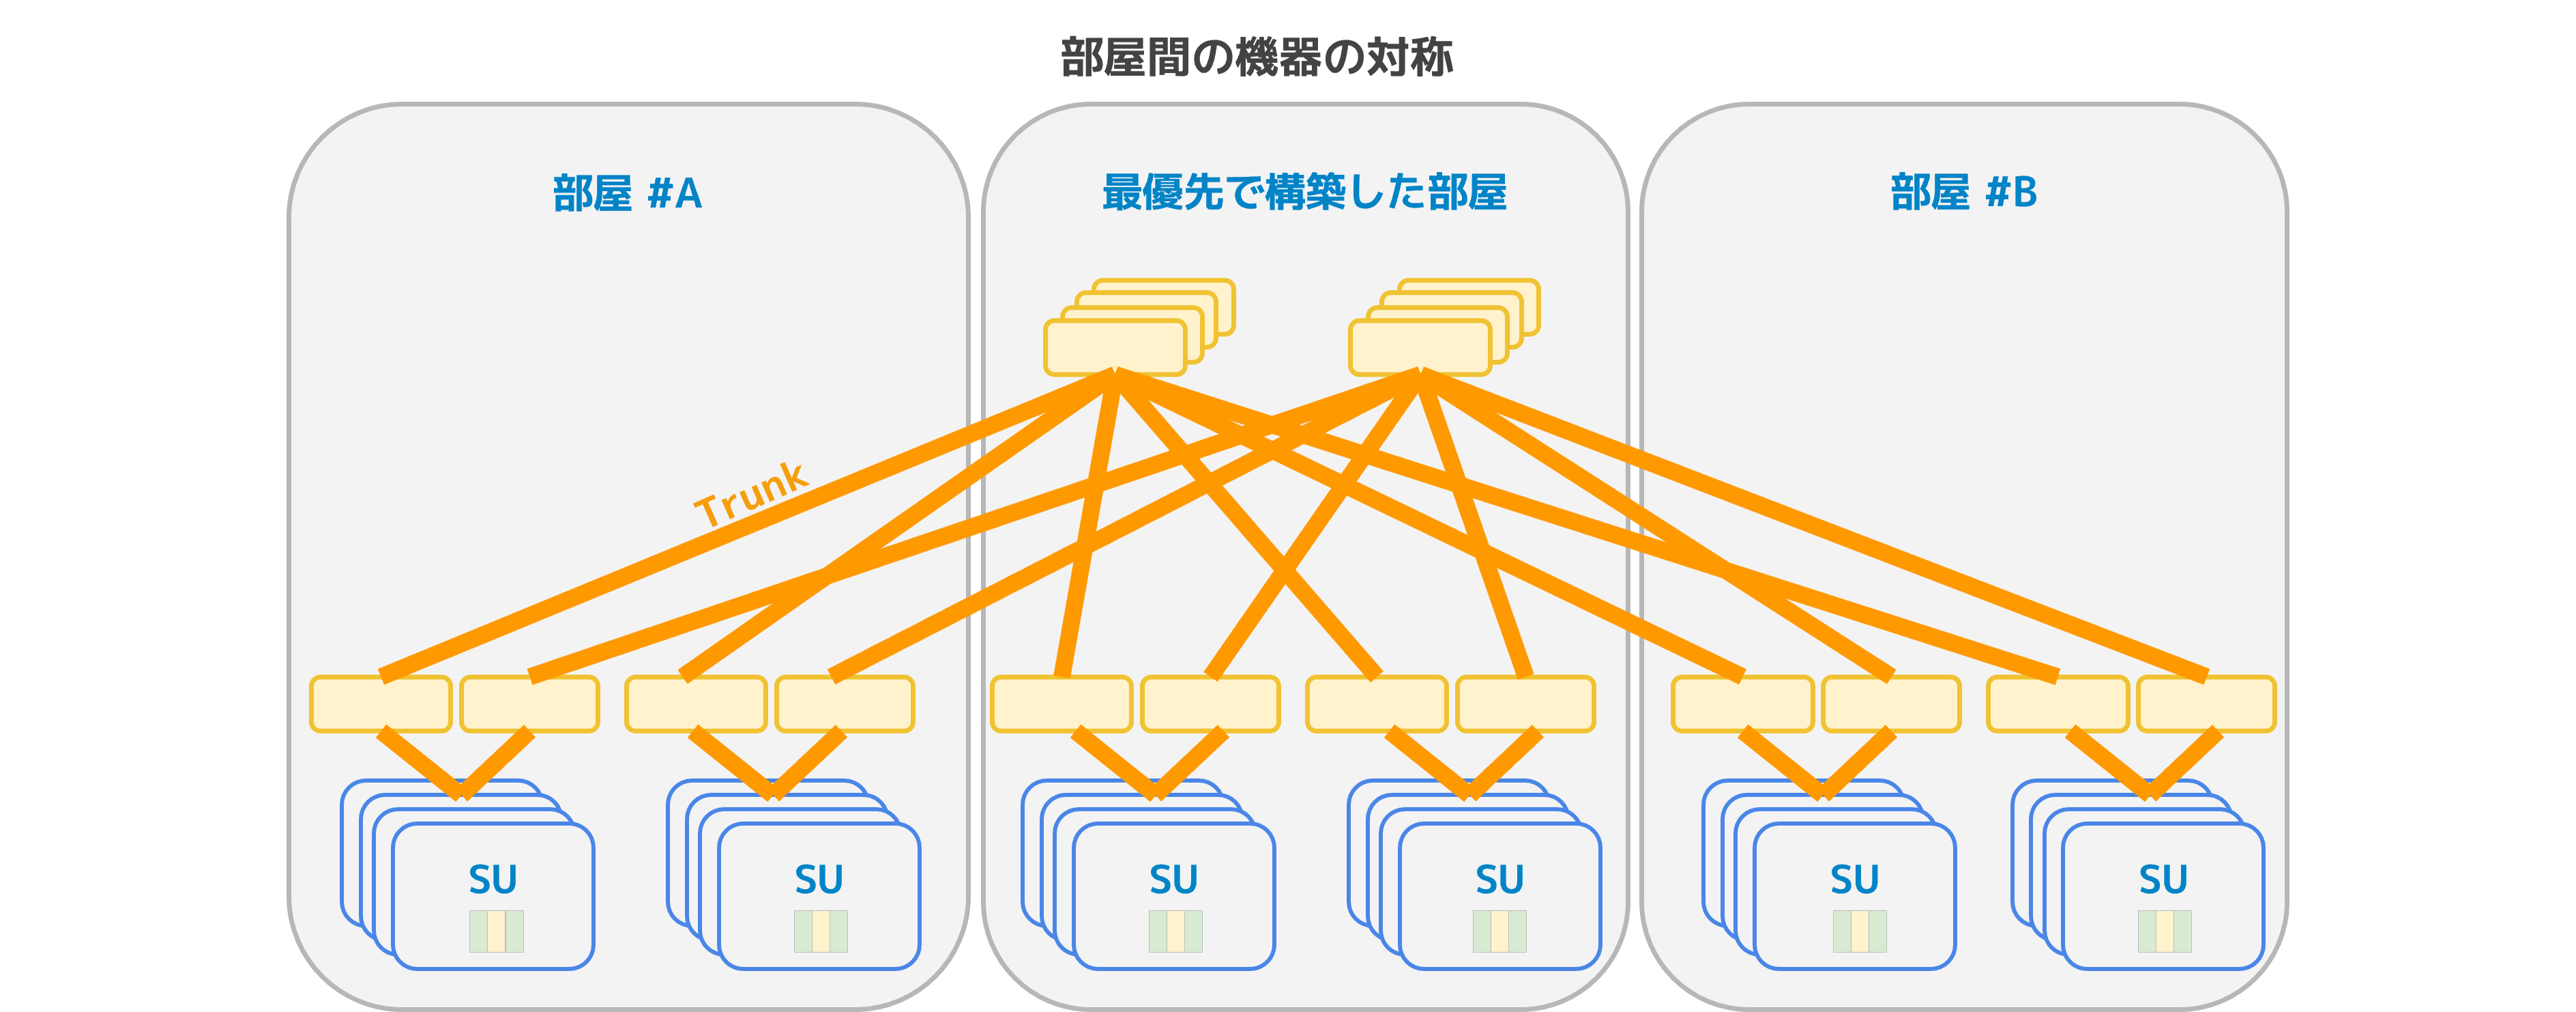
部屋間のSymmetric設計
ケーブリング工事が終わった後、別の問題が発生しました。GPUとSwitchを接続した後、全リンクに対して通信性能を測定すると、一部のリンクだけ本来の性能を大幅に下回っていました。
ところが現場で確認すると、
・LEDは正常
・Link StatusはUP
・光パワーも正常範囲
という状態でした。
一見すると正常なリンクです。GPUからSwitchまでの経路には、NIC、Optics、Fiber、Connector、Breakout Boardなど多くのコンポーネントがあります。
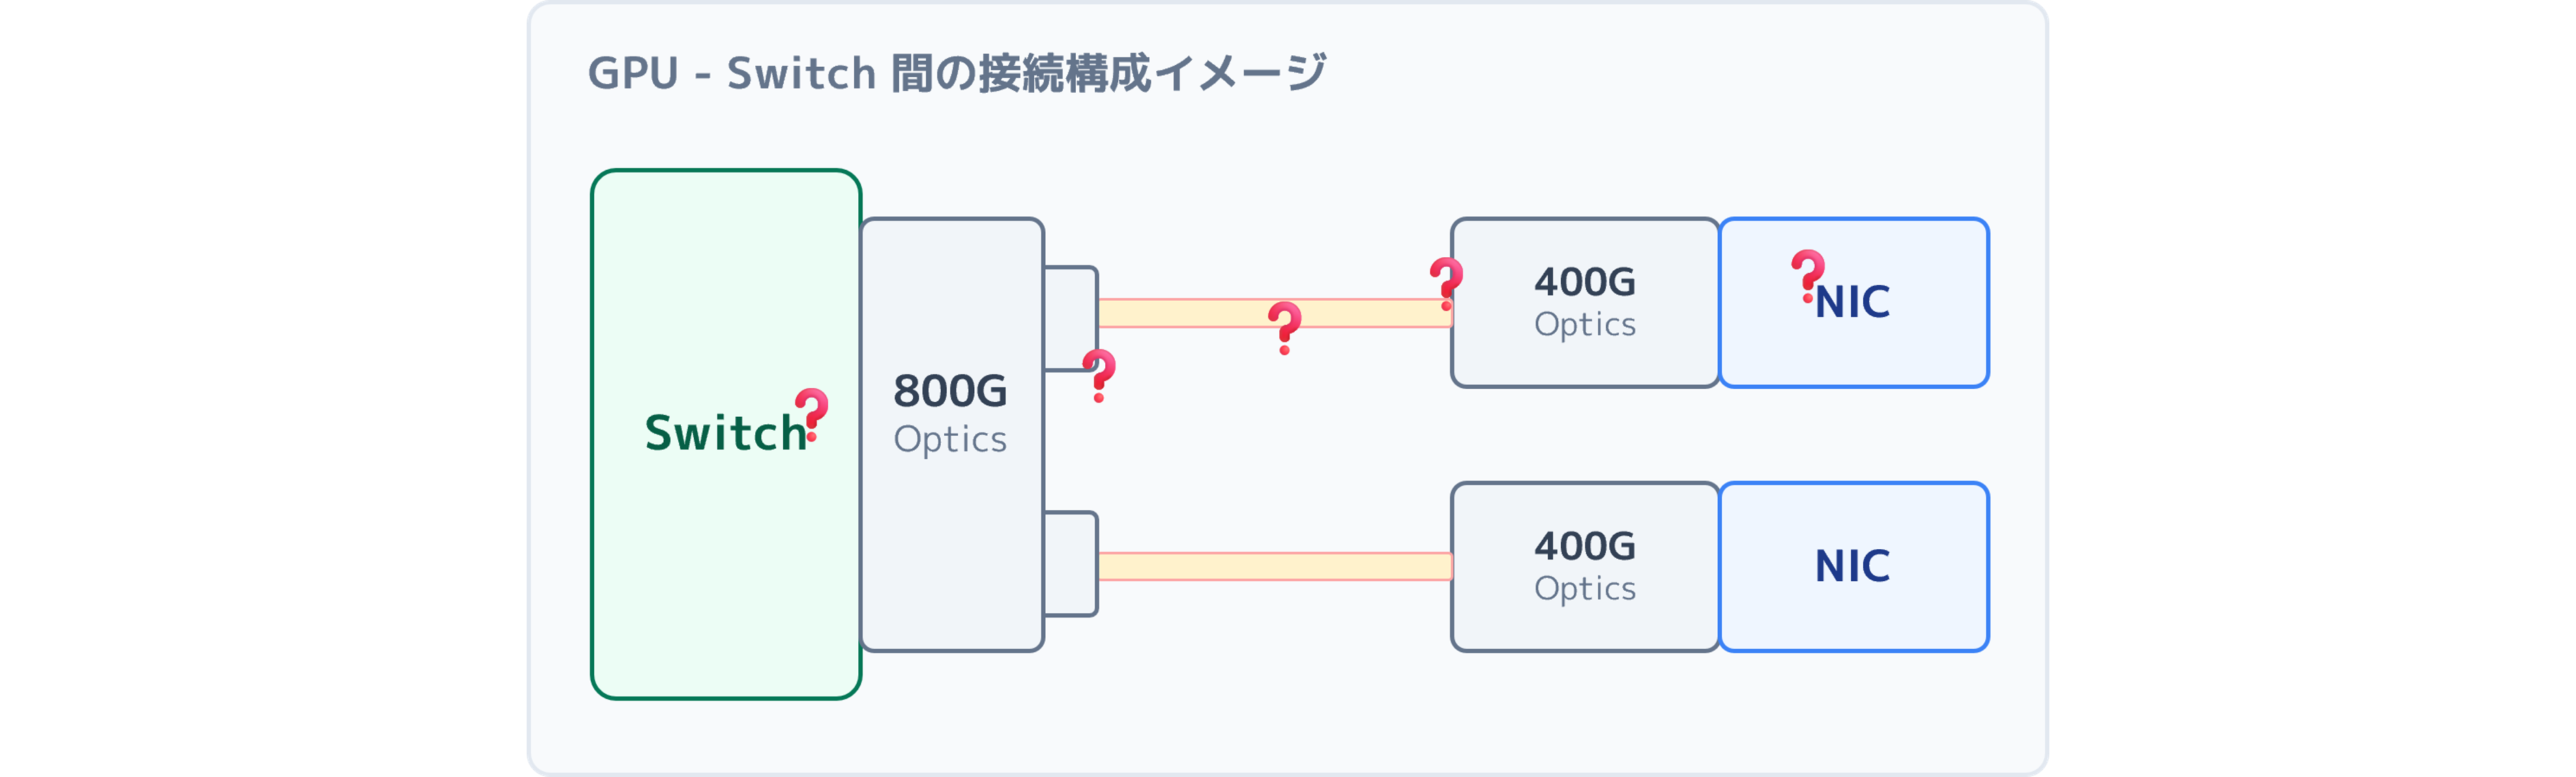
800G SwitchとCompute Tray NIC間の結線イメージ
どこで問題が発生しているのか、一つずつ切り分ける必要がありました。
Opticsの開発者とも議論しながら調査した結果、重要な手掛かりとなったのがBERとFECでした。
BER(Bit Error Rate)は、受信したBitのうち、どの程度のBit Errorが発生したのかを表す指標です。
例えば 10 億分の1を「1E-9」と表現し、基本的には値が小さいほど通信品質が良好であることを示します。
切り分けのポイントとして、BERの値が1E-8より小さい時を正常とすると、LaneのBER > 1E-7は異常と判断します。
実際に問題が発生した400Gインターフェースを調査したところ、下記の図の異常パターンにて、4つのLaneのうち一部だけBERが1E-6まで悪化していました。
そこでOpticsを交換するとBERが正常な範囲へ戻り、スループット低下も解消しました。
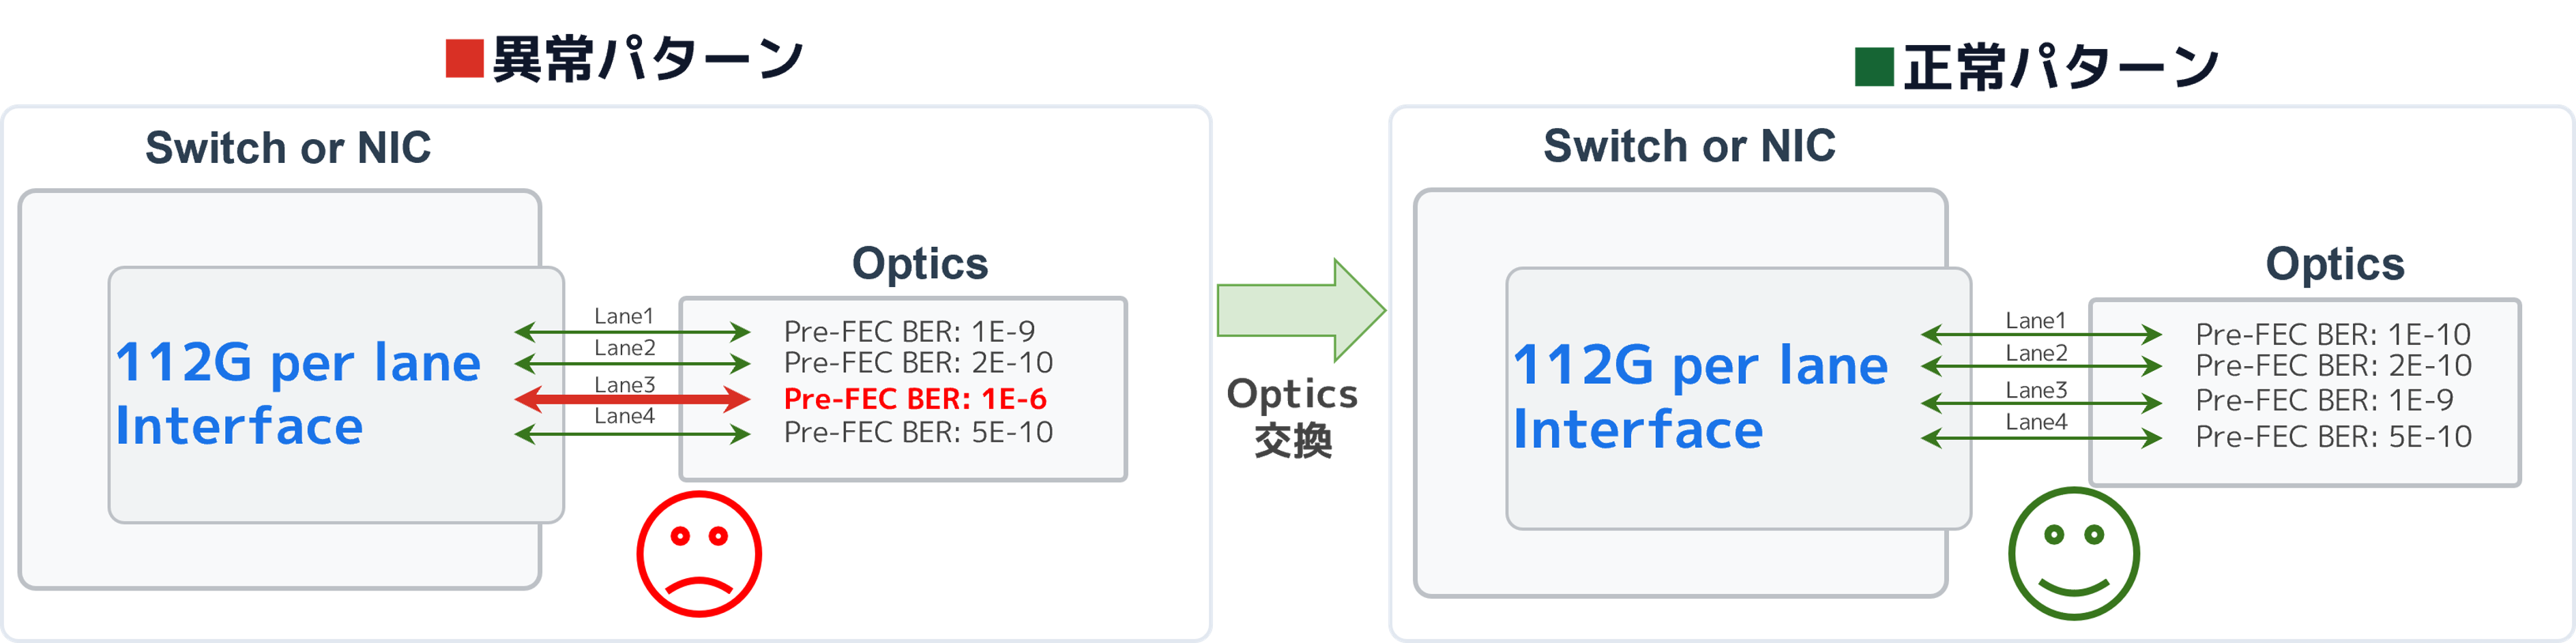
Optics交換前後のBERの変化のイメージ図
FEC(Forward Error Correction)の統計情報からは、Bit Errorがどの程度訂正されているかを確認できます。
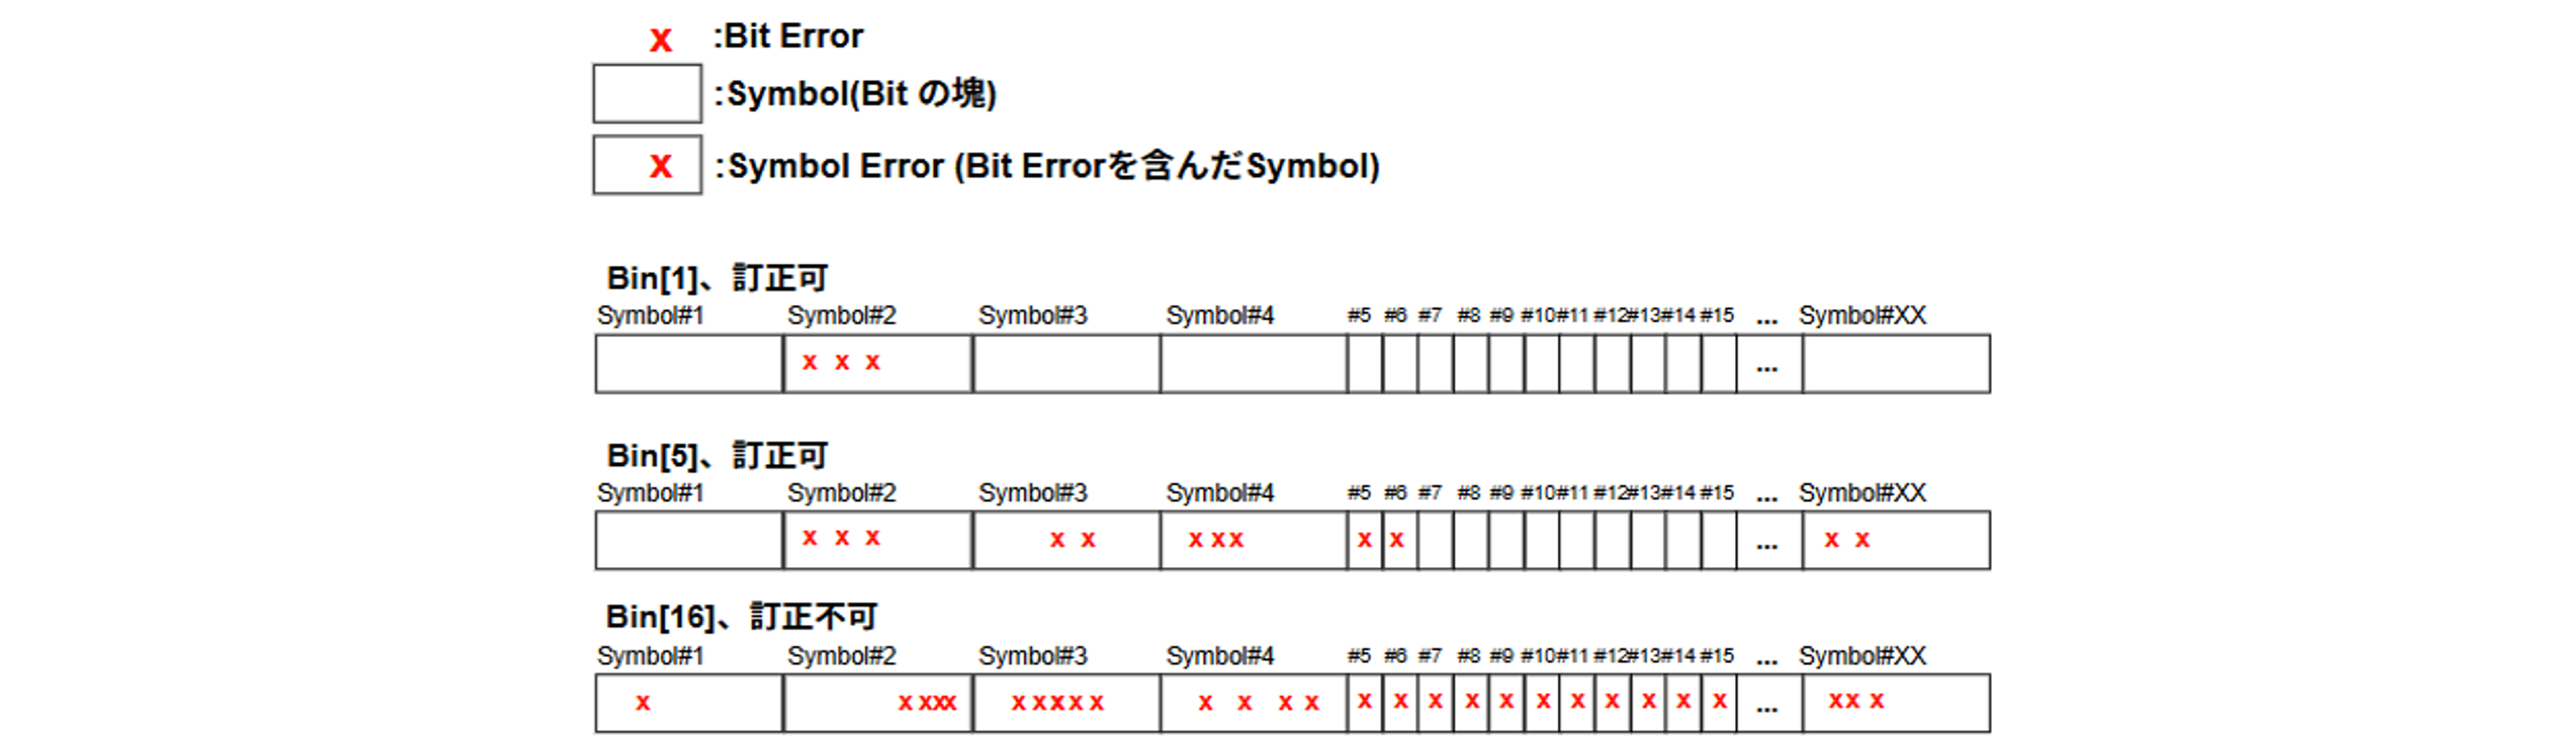
FECとSymbol Errorのイメージ図
FECでは複数のBitをまとめた単位をSymbolと呼び、Bit Errorを含むSymbolをSymbol Errorとして扱います。Histogramの ”Bin[XX]” は、検出されたSymbol Errorの数を表します。
EthernetのRS-FECアルゴリズムでは、Bin[0]〜Bin[15] は訂正可能、Bin[16] 以降は訂正不可能です。大きなBin値のカウントが増えている場合は、リンク品質が悪化している兆候と判断できます。
FECの統計情報を見ることで、リンク内でどの程度のエラーが発生し、それをどの程度訂正しているのかを把握できます。
下記の異常パターンでは、FECのSymbol Error分布においてBin[15] までカウントされていました。このことから、Symbol Errorが訂正限界を超え、訂正しきれないパケットが発生している可能性があり、これがリンク障害の一因になっていると判断しました。
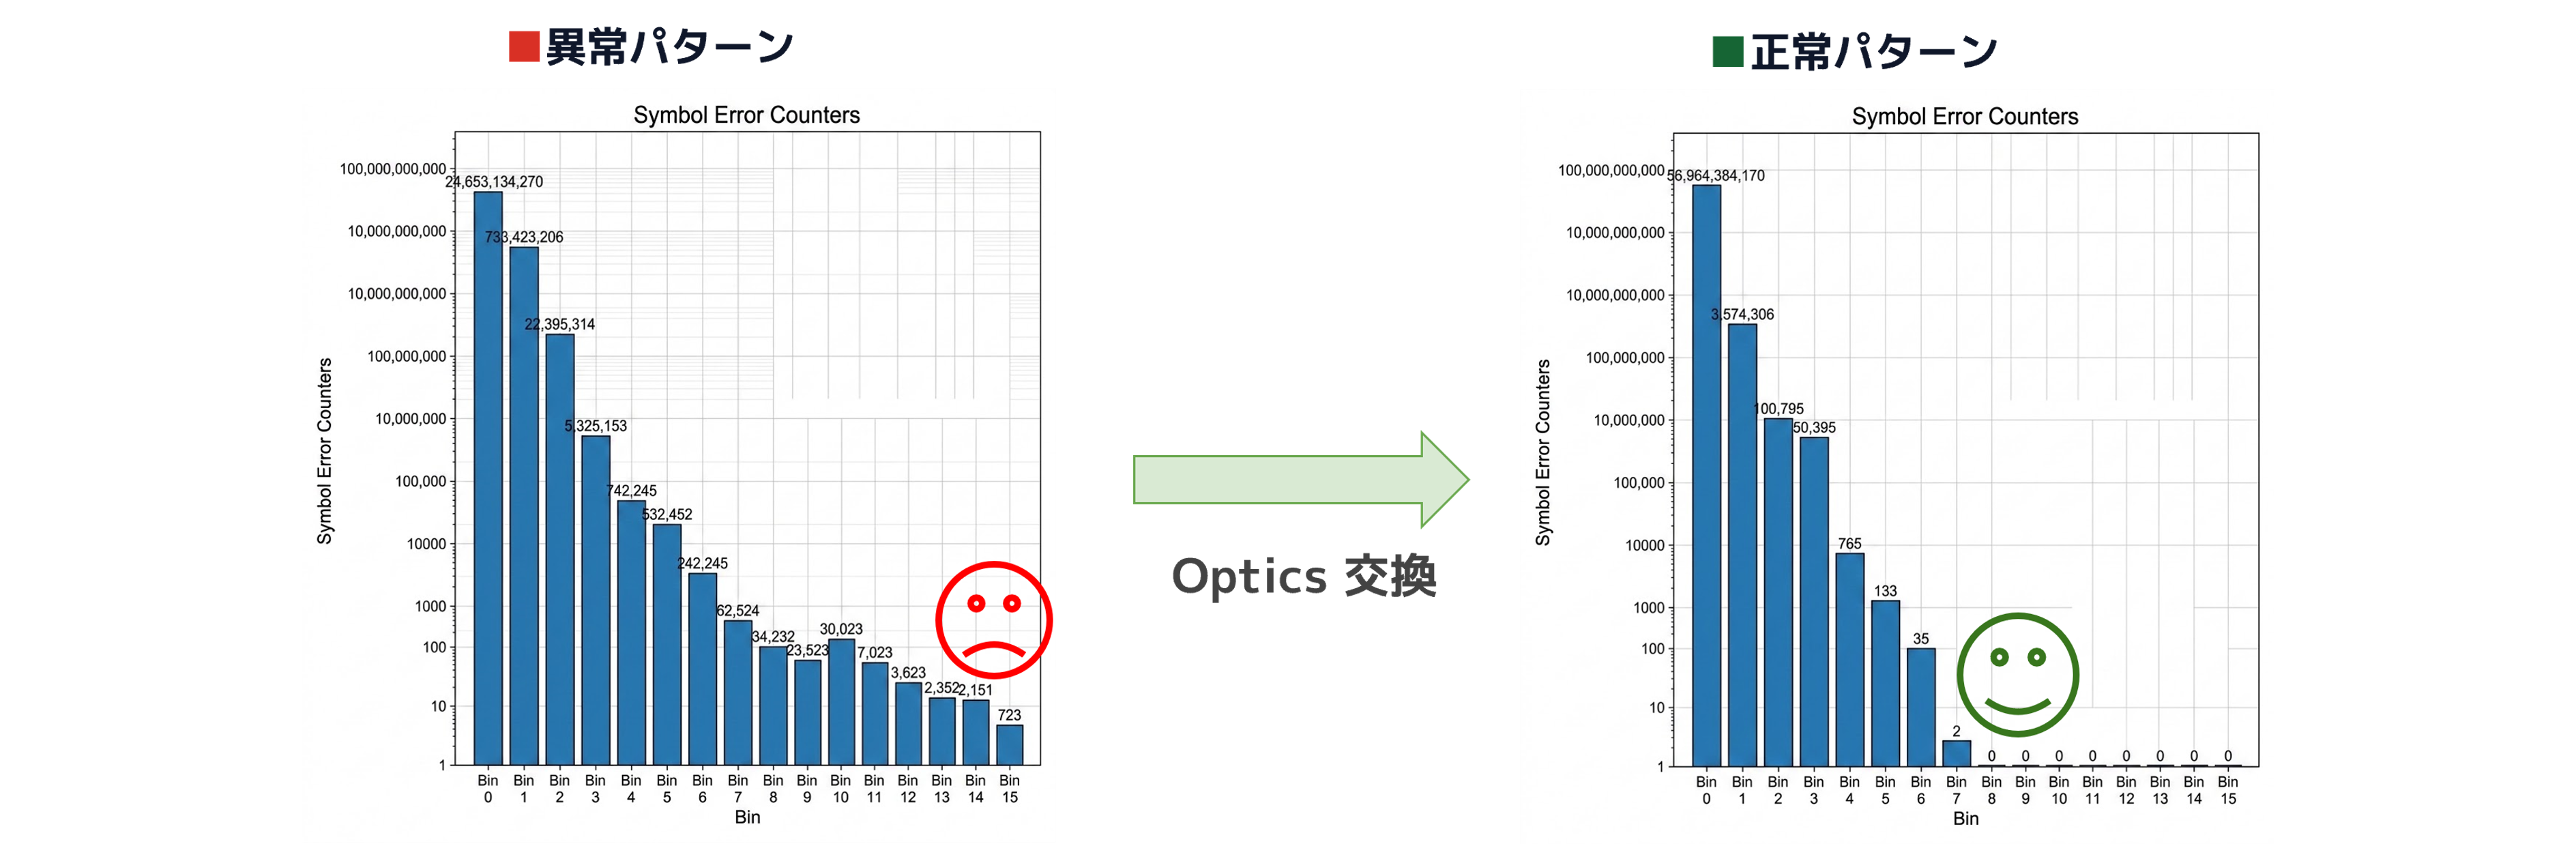
Optics交換前後のFEC Histogramの変化のイメージ図
該当するOpticsを交換すると、エラー分布が改善し、スループットも正常な状態へ戻りました。
この経験から分かったのは、「Link Up=正常」ではないということです。これまでのようにInterface Downだけを監視していては、リンク品質が徐々に劣化している状態を捉えられません。
そこで現在は、BERやFECなども活用し、障害が顕在化する前の劣化兆候を捉える監視への移行を検討しています。
Opticsのトラブルを経験したことで、「より故障しにくい部材を選択できないか」という検討も始めました。その選択肢の一つがAEC(Active Electrical Cable)です。
AECは、ケーブル両端に信号処理用のICを搭載し、Copper(銅線)を介して高速な電気信号を伝送するケーブルです。
OpticsにはLaserをはじめとする複数の光学コンポーネントが含まれています。一方、AECはCopperを利用し、光学コンポーネントを使用しません。そのため構造が比較的シンプルで、調達コストを抑えられるというメリットもあります。
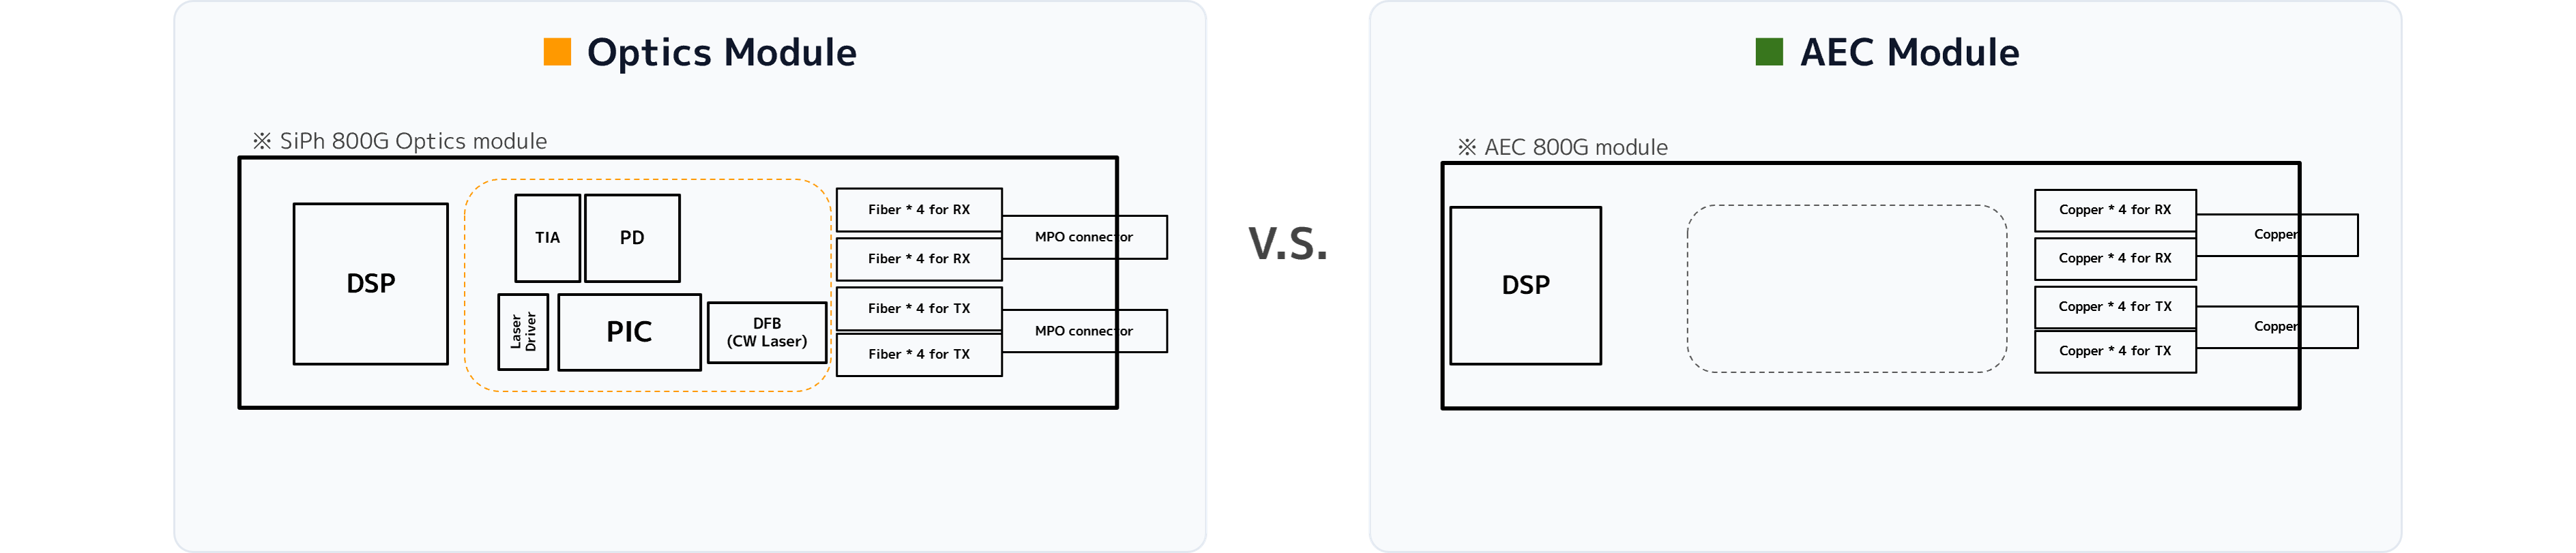
OpticsとAECモジュール部分のコンポーネントのイメージ図
もちろんAECのケーブル長には、800Gの場合最長7mの制約がありますが、ラック配置とケーブルルートを工夫すれば、Rack-Scale GPUサーバーでも利用できます。
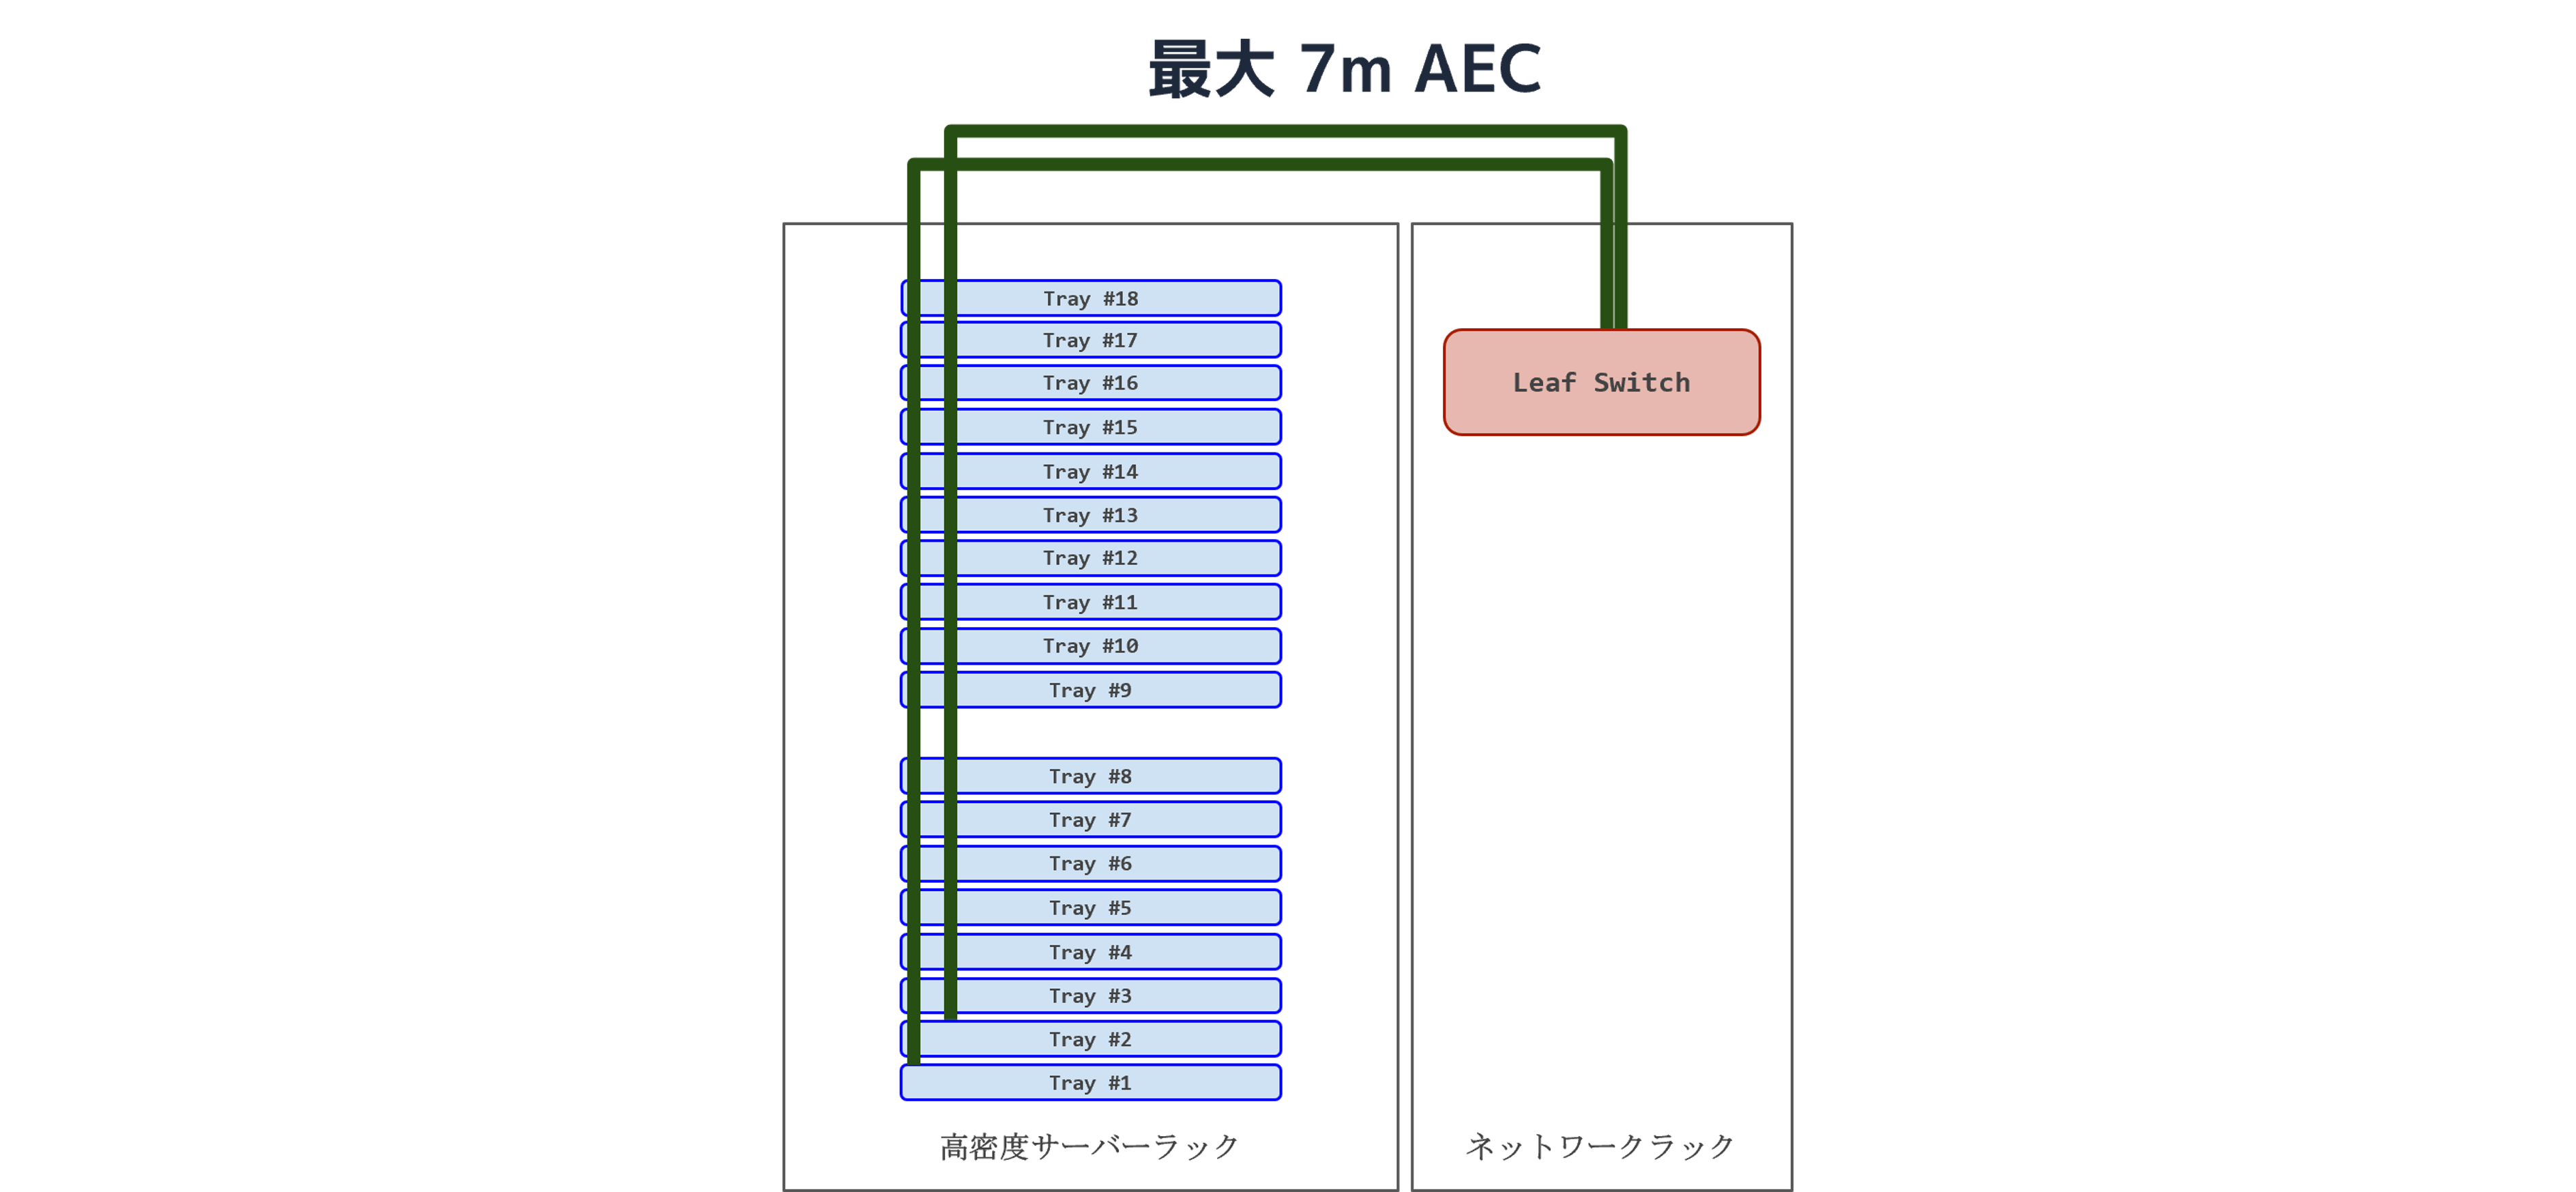
800G - 2x400G AECのラック間配線のイメージ図
これまで「Scale-out Network は光で接続する」という前提で考えていましたが、物理構成次第ではCopperも選択肢になることが分かりました。
Rack-Scale GPUサーバーの構築では、液冷特有のトラブルも経験しました。
故障したTrayを新しい機器へ交換した後、ラック全体の冷却性能が徐々に低下する現象が発生しました。調査したところ、新しく交換したTray内部が冷却液で完全に満たされておらず、内部に空気が残っていました。
その空気が冷却ループへ流れ込み、冷却液の循環を妨げたことで、ラック全体の冷却性能が低下していました。
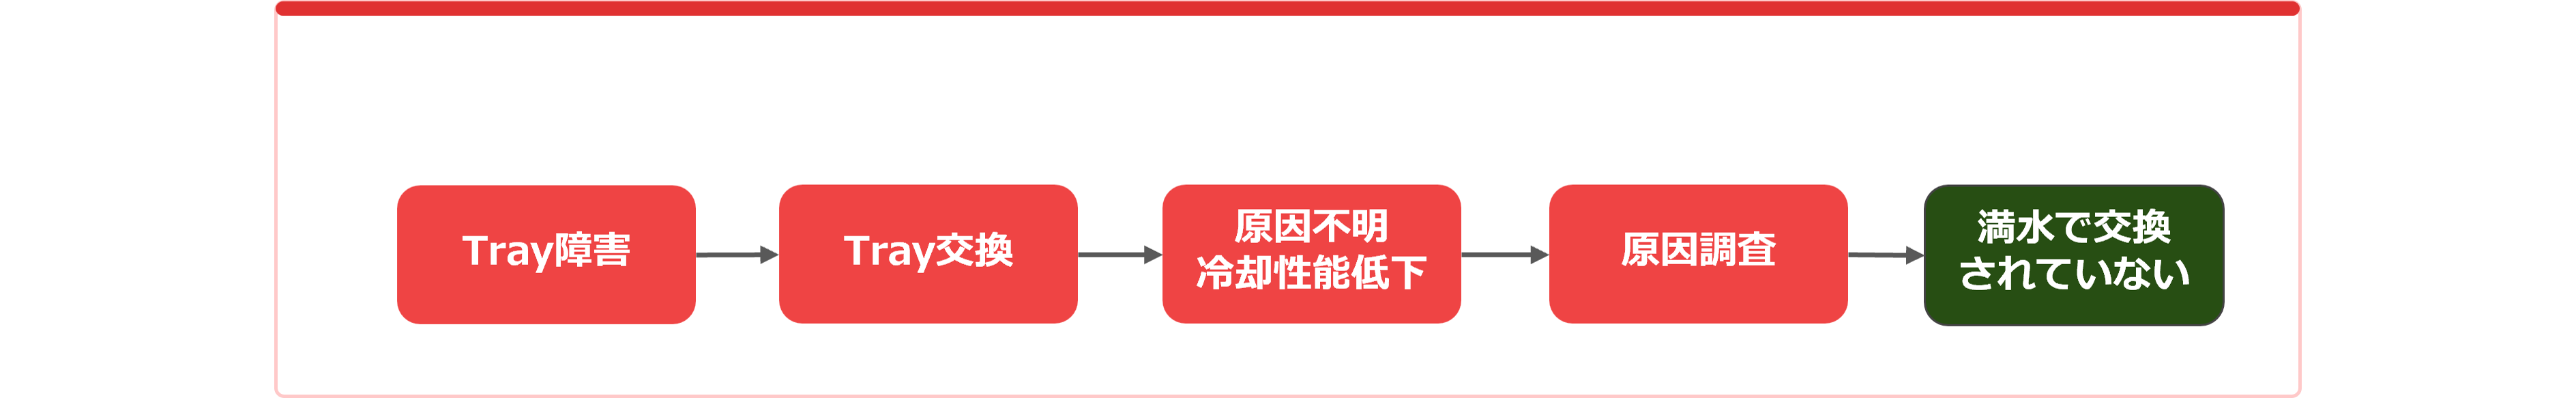
冷却性能のトラブルを発見・解決するまでの流れ
今後、液冷対応Switchなどが増えていけば、これはサーバーエンジニアだけの問題ではありません。ネットワークエンジニアも、水温、水圧、流量、冷却液の状態などを理解し、監視する必要があります。
今回の構築を通じて得られた知見は、大きく4つあります。
AI計算基盤では、ネットワークだけを理解していれば十分とは言えません。電源、液冷、サーバーコンポーネント、Optics、ケーブルなど物理インフラ全体への理解が求められます。
従来型GPUサーバーの設計をそのまま適用するのではなく、ラック全体を一つのシステムとして捉えて設計する必要があります。
物理構成の標準化、ケーブリングの単純化、高密度パッチパネル、Underlay Networkを活用した管理通信、AECの検討など、既存の方法を見直すことで構築速度やコストを改善できます。
BERやFECを用いたスループット低下の切り分けのように、現場の知識だけでは解決が難しい問題もあります。
開発者と議論しながら技術への理解を深めることで、複雑な障害に対しても迅速に原因を特定できるようになります。
Rack-Scale GPUサーバーの登場によって、ネットワークエンジニアが扱う領域は大きく広がりました。
Ethernet Fabricの設計だけでなく、ラックの電源構成、液冷設備、Optics、ケーブリング、物理層の品質、さらにはGPUリソースの提供方法まで、一つのシステムとして考える必要があります。
特に大規模AIネットワークでは、「Link Upしているから正常」「従来と同じ構成なら問題ない」といった考え方だけでは対応できないケースがあります。
物理層まで深く理解し、ファシリティやサーバーを含めた領域横断的な設計を行うこと。そして、構築・運用で得られたデータを次の設計へフィードバックすることが、安定した AI計算基盤を構築するうえで重要になります。
Rack-Scale GPUサーバーのネットワークは、まさに「苦悩と挑戦の積み重ね」です。
今回得られた知見を、今後のより大規模で安定した AI計算基盤の構築・運用へつなげていきます。
JANOG58 MEETING IN MATSUYAMA, Rack-Scale GPUサーバーのNW設計と運用までの苦悩, 登壇資料-内田-泰広-張-朝程
JANOG58 IN MATSUYAMA, Rack-Scale GPUサーバーのNW設計と運用までの苦悩, アーカイブ配信(2027年1月31日(日)まで公開)
「NVIDIA GB200 NVL72」を搭載した AI計算基盤が稼働開始
JANOG57 IN OSAKA, ライトニングトーク, 安定した800G DCNWを求めて~トランシーバのBER計測~
SONiC Workshop Japan 2025, SONiCで800G AECケーブルを検証してみた